Samenvatting
LLM-training op beperkte hardware vraagt om QLoRA en DoRA, maar dynamische dekwantisatie kost 20% tot 35% TPS.
LLM-training met QLoRA en DoRA
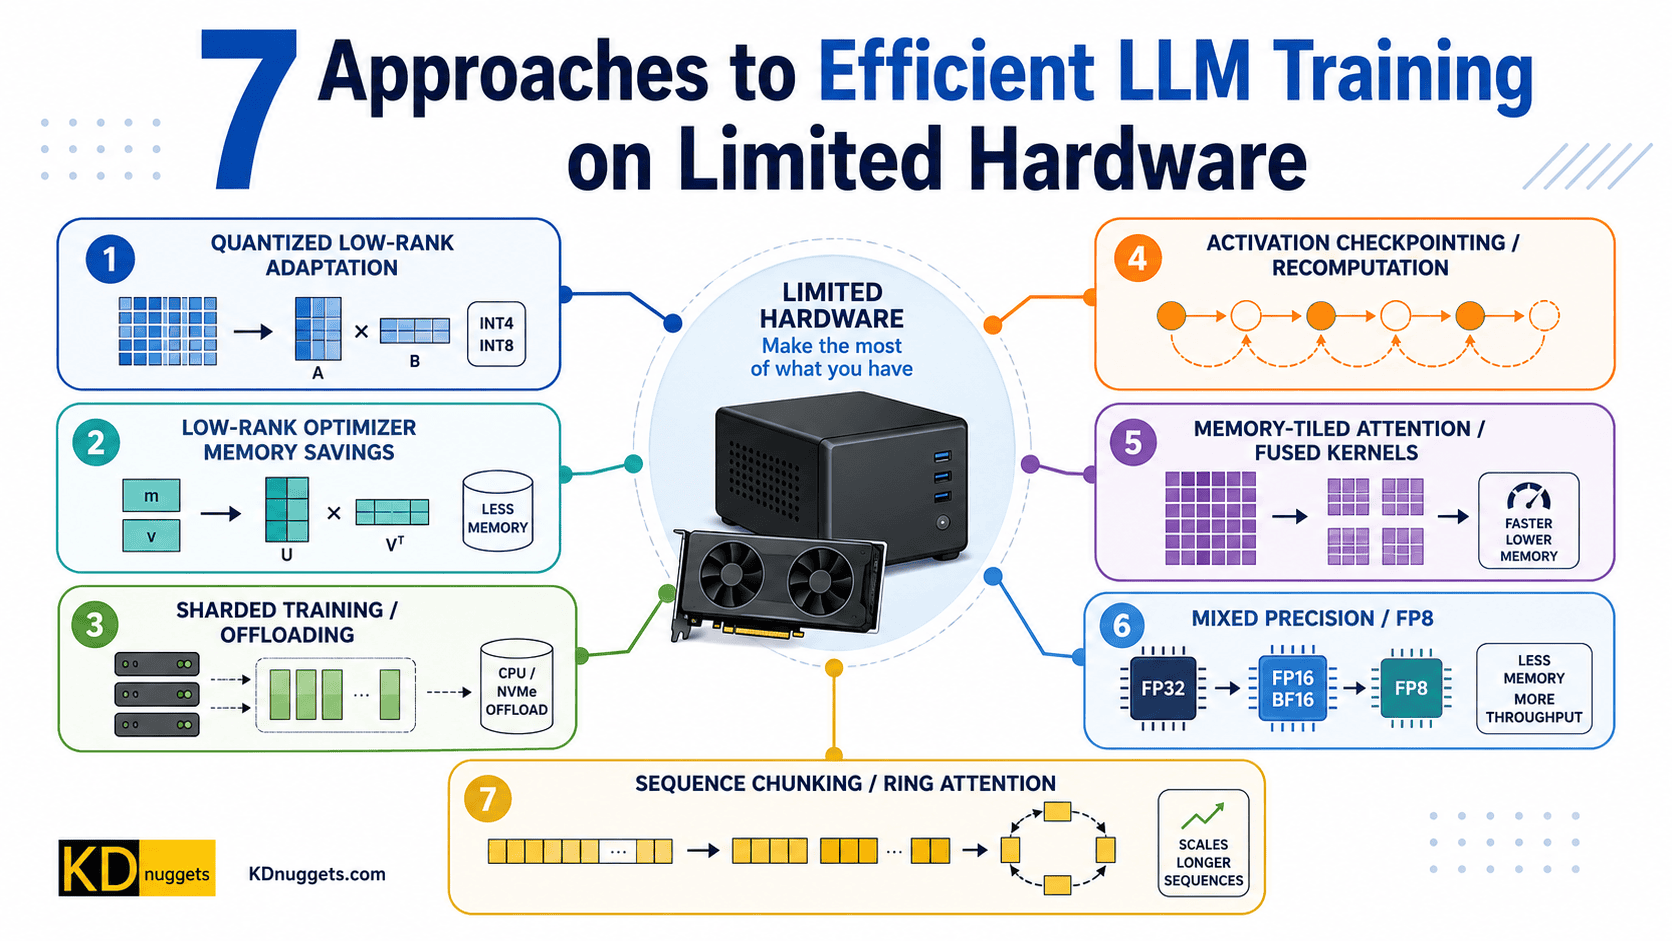
Het artikel bespreekt zeven technieken om grote taalmodellen op consument-GPU’s te trainen zonder direct tegen de VRAM-limiet aan te lopen. De beschreven hardware bestaat uit dual- of quad-workstations met bijvoorbeeld RTX 4090-, A10G- of L40S-GPU’s en 24 GB tot 48 GB VRAM per apparaat.
Een standaard 7B-model in FP16 of BF16 gebruikt al 14 GB voor gewichten. AdamW voegt ongeveer 56 GB aan optimizerstatus toe, terwijl gradients en activaties extra geheugen vragen. Daardoor faalt de standaardaanpak al vóór de eerste trainingsstap.
De eerste uitgewerkte methode is Quantized Low-Rank Adaptation, met QLoRA en DoRA. QLoRA bevriest de basisgewichten in een 4-bit NormalFloat-representatie en voegt trainbare low-rank-matrices toe. Double Quantization bespaart daarnaast 0,37 bits per parameter. DoRA splitst updates op in richting en magnitude.
Waarom QLoRA en DoRA belangrijk zijn
De aanpak maakt een scherp onderscheid tussen statisch geheugen voor gewichten, optimizerstatus en gradients, en tijdelijk geheugen voor activaties en werkbuffers. Dat onderscheid helpt engineers bepalen of een trainingstaak tegen rekenkracht of tegen geheugenbandbreedte aanloopt.
QLoRA en DoRA verminderen het geheugengebruik, maar leveren niet gratis snelheid op. Tijdens de forward pass zet het systeem de 4-bit gewichten tijdelijk om naar BF16. Die stap verlaagt de trainingsdoorvoer met 20% tot 35% ten opzichte van native 16-bit-training. Voor serveren zonder extra latency moeten adapters bovendien terug in het basismodel worden samengevoegd, wat de gewichten opnieuw naar 16-bit brengt.
Concrete takeaway voor LLM-training
Breng vóór je een trainingsrun start het geheugen per onderdeel in kaart: gewichten, optimizerstatus, gradients en activaties. Kies QLoRA of DoRA wanneer VRAM de beperkende factor is, maar meet TPS afzonderlijk en plan de precisieconversie mee als je adapters later wilt samenvoegen.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankWat is Power BI? Alles wat je moet weten
Ontdek wat Microsoft Power BI is, hoe het werkt, wat het kost en waarom het de populairste BI-tool ter wereld is. Comple...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
Gerelateerde artikelen

Python: 10 bibliotheken voor LLM-applicaties
Python krijgt krachtige bibliotheken voor LLM-applicaties die fine-tuning en modelimplementatie versnellen.

LLM engineer worden: roadmap voor 2026
LLM engineer worden: roadmap voor 2026 benadrukt de vaardigheden nodig om LLM-applicaties succesvol te implementeren.

5 Krachtige Python Decorators om LLM-toepassingen te optimaliseren
Dit artikel bespreekt vijf krachtige Python decorators die specifiek zijn ontwikkeld om LLM-toepassingen te optimalisere...

LLM: versnellen met DSpark speculative decoding
LLM: DSpark speculative decoding versnelt inference op bestaande GPU zonder extra hardware.