Samenvatting
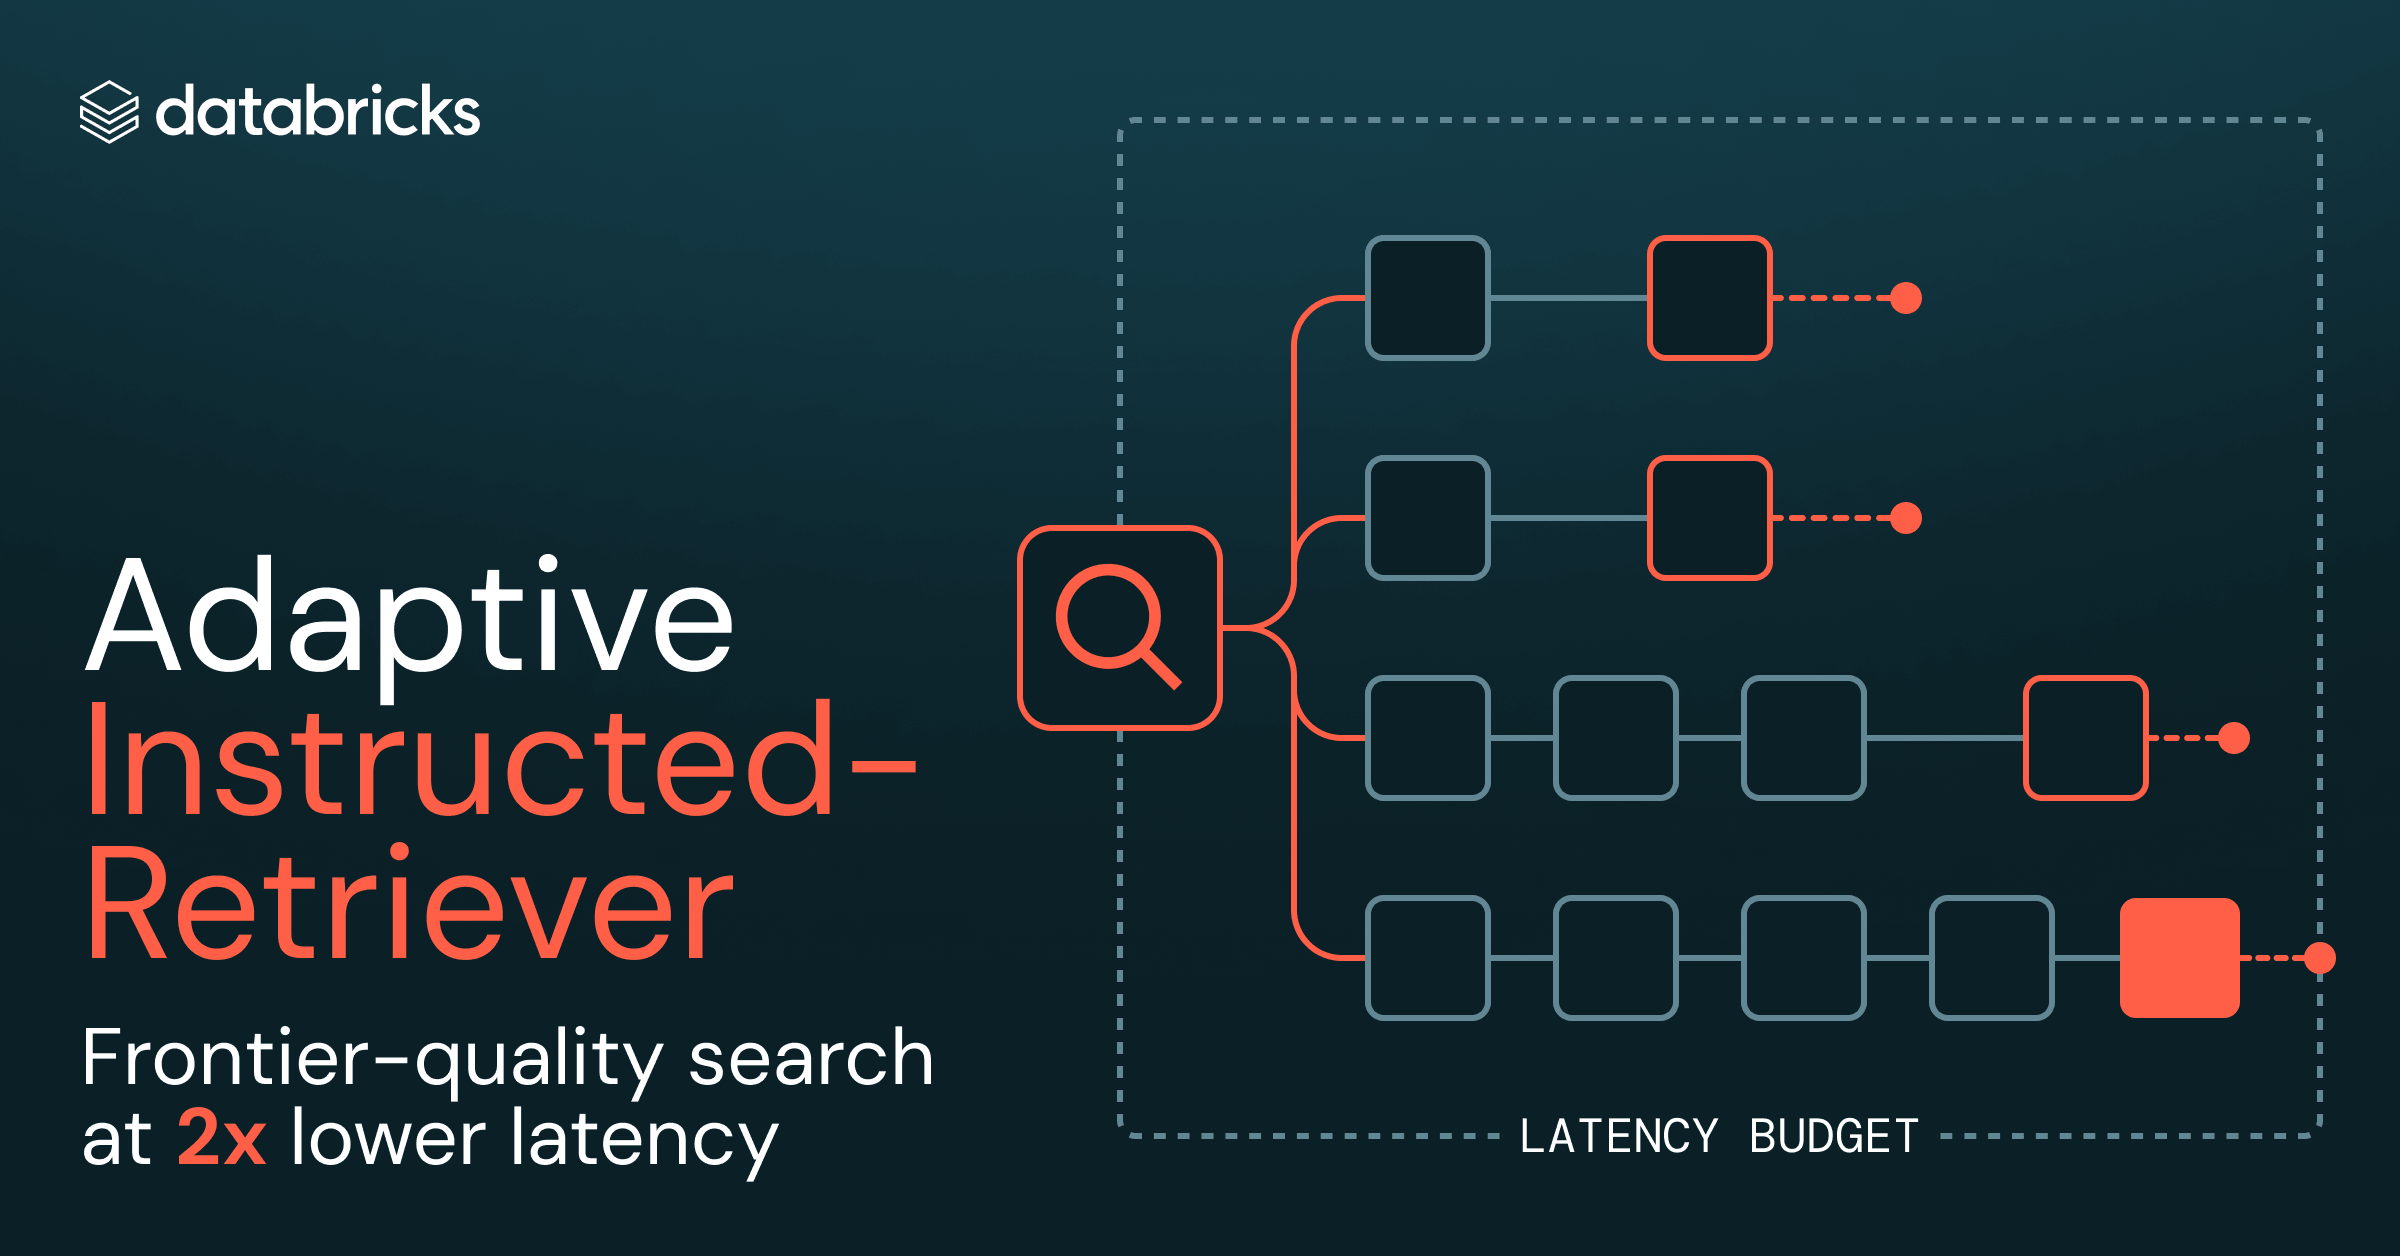
Adaptive Instructed-Retriever combineert parallelle en sequentiële zoekstappen voor enterprise retrieval met 2x lagere latentie.
Adaptive Instructed-Retriever: wat er gebeurt
Databricks introduceert Adaptive Instructed-Retriever als zoeklaag voor enterprise data agents. Het model gebruikt parallelle retrieval wanneer het bewijs snel duidelijk is en schakelt alleen bij complexere vragen over op sequentiële zoekstappen.
Die aanpak richt zich op multi-hop-vragen, waarbij een agent in meerdere rondes bewijs verzamelt en zoekopdrachten verfijnt. Adaptive Instructed-Retriever begrenst het maximale aantal sequentiële stappen vooraf. Het model stopt zodra voldoende bewijs beschikbaar is, of zoekt door tot de ingestelde limiet wanneer extra stappen de kwaliteit waarschijnlijk verbeteren.
Databricks meldt dat het model op eigen enterprise-benchmarks en publieke retrieval-benchmarks vergelijkbare kwaliteit haalt als toonaangevende third-party- en open-source modellen, met 2x lagere latentie. De training gebruikt synthetische enterprise-omgevingen en een agentic data-syntheseproces dat aansluit op Instructed-Retriever-1 en het KARL-rapport.
Waarom Adaptive Instructed-Retriever belangrijk is
Enterprise data agents zoeken niet alleen in tabellen. Genie Code, de data agent van Databricks, moet ook notebooks, dashboards en documenten vinden in een veranderende workspace. Een zoekmethode die voor elke vraag meerdere rondes uitvoert, kan extra vertraging veroorzaken; een methode met één stap mist juist bewijs bij ingewikkelde vragen.
Adaptive Instructed-Retriever behandelt die afweging per verzoek. Daarmee positioneert Databricks het model tussen snelle parallelle retrieval en uitgebreidere sequentiële search. De vergelijking met third-party- en open-source modellen maakt bovendien duidelijk waarop Databricks de prestaties beoordeelt: retrievalkwaliteit én latentie.
Concrete takeaway
Test voor enterprise agents niet alleen of de juiste bron wordt gevonden, maar ook hoeveel zoekstappen daarvoor nodig zijn. Let bij evaluaties op multi-hop-vragen, de ingestelde staplimiet en het verschil tussen éénstaps- en sequentiële retrieval.
Verdiep je kennis
Kennisbank
Data lakehouse uitgelegd — Het beste van twee werelden
Wat is een data lakehouse en waarom combineert het het beste van data warehouses en data lakes? Vergelijking, architectu...
KennisbankData-driven werken — Hoe begin je als organisatie?
Leer hoe je als organisatie data-driven gaat werken. Van data-volwassenheid tot cultuurverandering: een praktisch stappe...
KennisbankETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
Gerelateerde artikelen
Databricks: hoogwaardige en vertrouwde dataproducten bouwen
Databricks beschrijft hoe organisaties betrouwbare dataproducten bouwen voor teams, applicaties en nieuwe data-aanbiedin...

Lever kwalitatieve enterprise AI-agents aan zakelijke gebruikers met Agent Bricks en Databricks Apps
Databricks introduceert Agent Bricks, een platform dat bedrijfsgebruikers in staat stelt om kwalitatieve AI-agenten te o...

Databricks: versnel zoekopdrachten met tekstindexen
Databricks: versnel zoekopdrachten met tekstindexen zonder applicatiewijzigingen.

Business analytics tools: Gids voor datagedreven organisaties
Data-analyse tools zijn cruciaal voor organisaties die datagedreven willen opereren.