Samenvatting
Lakebase Postgres verdubbelt de throughput dankzij een vernieuwde compute-cache, met minder storage-reads en lagere latency.
Lakebase Postgres compute-cache: wat er gebeurt
Databricks beschrijft verbeteringen aan de cache op de Postgres-compute van Lakebase Postgres. De vernieuwde cache werkt samen met shared buffers en past zich aan de beschikbare compute aan via autoscaling.
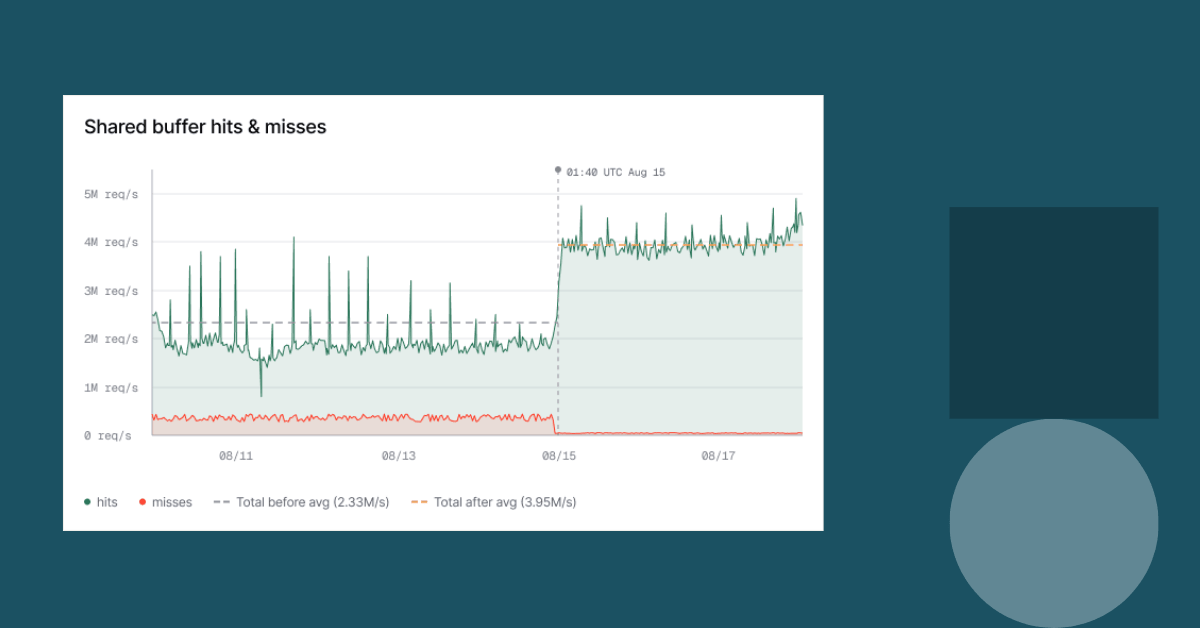
De aanpak moet zoveel mogelijk data in DRAM beschikbaar houden. Productieresultaten laten volgens Databricks 2x throughput zien, naast minder reads uit de storage-laag en lagere latency. De verbeteringen zijn al naar klanten gebracht; de blog beschrijft ook plannen voor de nabije termijn.
Lakebase Postgres en het standaard Postgres-cachemodel
Standaard gebruikt Postgres shared buffers naast de page cache van het besturingssysteem. Dat leidt tot double buffering: dezelfde pagina kan in beide geheugengebieden staan. Bij een compute met 4 GB RAM en 1 GB shared buffers verbruikt het systeem daardoor 2 GB geheugen om 1 GB data te cachen.
Lakebase Postgres gebruikt disaggregated storage. Data komt daarbij niet via het filesystem of de page cache van het besturingssysteem binnen. Bovendien staat de omvang van shared buffers vooraf vast en vereist een wijziging een herstart. Dat botst met een serverless systeem dat compute automatisch aanpast.
De cache moet daarom rekening houden met de manier waarop Lakebase Postgres storage en compute scheidt. Ook het geheugenverbruik per actieve verbinding speelt mee: grotere shared buffers vragen extra geheugenbeheer door het besturingssysteem.
Concrete takeaway voor Lakebase Postgres
Controleer bij Lakebase Postgres-workloads niet alleen de databaseconfiguratie, maar ook de verdeling tussen compute-cache, shared buffers en storage-reads. Gebruik throughput, latency en het aantal reads uit de storage-laag als meetpunten wanneer je de nieuwe cache beoordeelt.
Verdiep je kennis
Kennisbank
Data lakehouse uitgelegd — Het beste van twee werelden
Wat is een data lakehouse en waarom combineert het het beste van data warehouses en data lakes? Vergelijking, architectu...
KennisbankETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
Gerelateerde artikelen

Lakebase-architectuur: 5x snellere Postgres-schrijfsnelheid
Lakebase-architectuur verbetert Postgres-schrijfsnelheid met 5x door scheiding van rekenkracht en opslag.

Database Branching in Postgres: Git-achtige workflows met Databricks Lakebase
Met de introductie van database branching in Postgres via Databricks Lakebase, kunnen ontwikkelaars nu Git-achtige workf...

Beheer je data: klantbeheerde sleutels voor Lakebase
Lakebase krijgt klantbeheerde sleutels die databeveiliging verbeteren en naleving vereenvoudigen.

Lakebase Search: agent-native ophalen in Lakebase Postgres
Lakebase Search: agent-native ophalen transformeert operationele zoekprocessen.