Samenvatting
Effectieve evaluaties voor AI-agents maken wijzigingen in prompts, tools en modellen meetbaar.
Effectieve evaluaties voor AI-agents: wat er gebeurt
Het artikel van KDnuggets beschrijft hoe je evals bouwt voor AI-agents. Zo’n evaluatie geeft een agent een taak, controleert het resultaat aan vooraf bepaalde criteria en herhaalt die test bij nieuwe versies of wijzigingen.
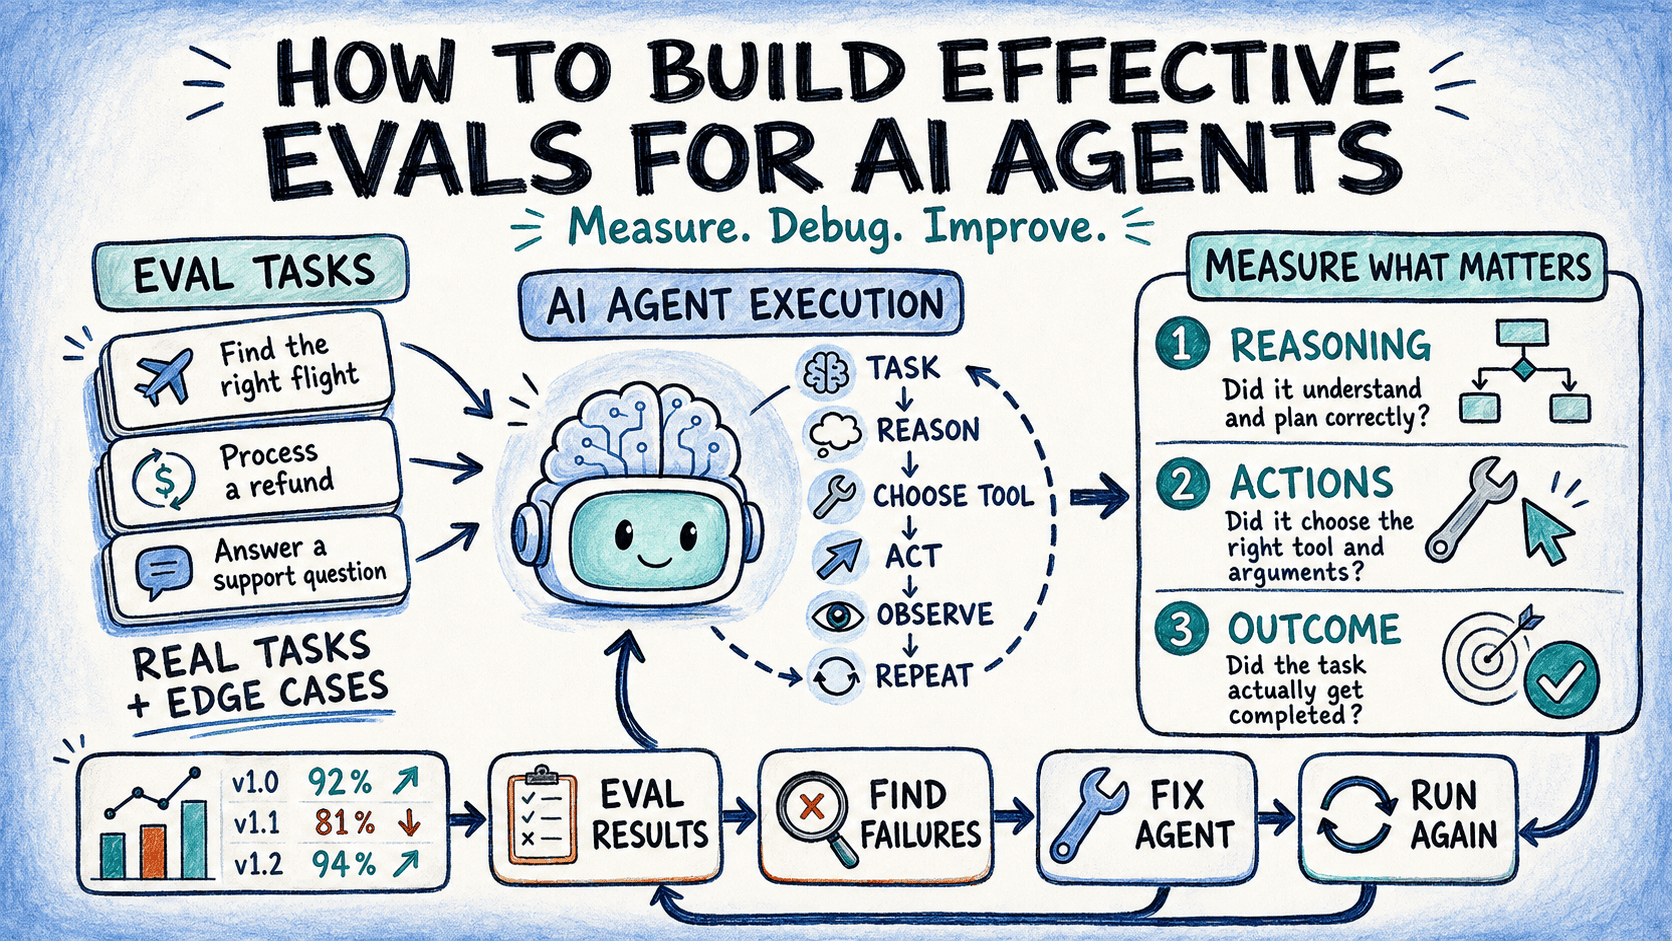
AI-agents vragen om een andere testaanpak dan single-turn LLM-calls. Een agent redeneert, kiest tools, voert acties uit, verwerkt observaties en herhaalt dat proces soms tientallen keren. Een vroege fout verandert de toestand voor alle volgende stappen. Daarom verdeelt het artikel fouten in drie lagen: reasoning, action en overall execution.
De voorgestelde aanpak combineert duidelijke taken, passende graders en een eval harness die resultaten zonder onnodige ruis verzamelt. Graders kunnen afzonderlijk kijken naar redenering, tool calls en het eindresultaat. Evals staan naast monitoring: ze meten gecontroleerde taken, terwijl monitoring het gedrag tijdens gebruik volgt.
Waarom AI-agent-evaluaties belangrijk zijn
Een agent kan slechter lijken te presteren zonder dat meteen duidelijk is waarom. Een aangepaste system prompt, gewijzigde toolbeschrijving of andere modelversie kan het gedrag veranderen. Zonder vaste meting blijven teams handmatig testen en gissen naar de oorzaak.
De gelaagde beoordeling maakt een probleem specifieker. Een reisagent kan bijvoorbeeld de verkeerde volgorde kiezen, een tool met verkeerde argumenten aanroepen of de taak inefficiënt uitvoeren. Die indeling helpt BI-teams om niet alleen vast te stellen dat een agent faalt, maar ook welk onderdeel nader onderzoek vraagt. De vergelijking met single-turn tests laat bovendien zien waarom één verwacht antwoord onvoldoende is voor meerstapsprocessen.
Concrete takeaway voor AI-agent-evaluaties
Leg per agent duidelijke taken vast, beoordeel reasoning, action en uitvoering afzonderlijk en draai dezelfde evals na elke wijziging in de system prompt, toolbeschrijving of modelversie.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankWat is Power BI? Alles wat je moet weten
Ontdek wat Microsoft Power BI is, hoe het werkt, wat het kost en waarom het de populairste BI-tool ter wereld is. Comple...
Gerelateerde artikelen

AI: hoe AI-agents datawetenschap transformeren in 2026
Power BI krijgt AI-agents die datawetenschap transformeren en het werk van analisten versnellen.

Verbeter AI-agents met Google Antigravity-vaardigheden
Google heeft zijn Antigravity-technologie gelanceerd voor het verbeteren van AI-agents, gericht op het automatiseren van...

Abacus AI: eigenschappen en automatisering van AI-agents
Abacus AI biedt een uitgebreide AI-oplossing die automatisering van taken en media-generatie mogelijk maakt.

Aan de slag met Nanobot: Bouw je eerste AI Agent
Ontdek hoe je met Nanobot eenvoudig je eigen AI-agent bouwt en verbindt met WhatsApp voor continue ondersteuning.