Samenvatting
Scikit-LLM koppelt taalmodellen aan scikit-learn, met ZeroShotGPTClassifier en GPTVectorizer voor herbruikbare pipelines.
Wat Scikit-LLM doet
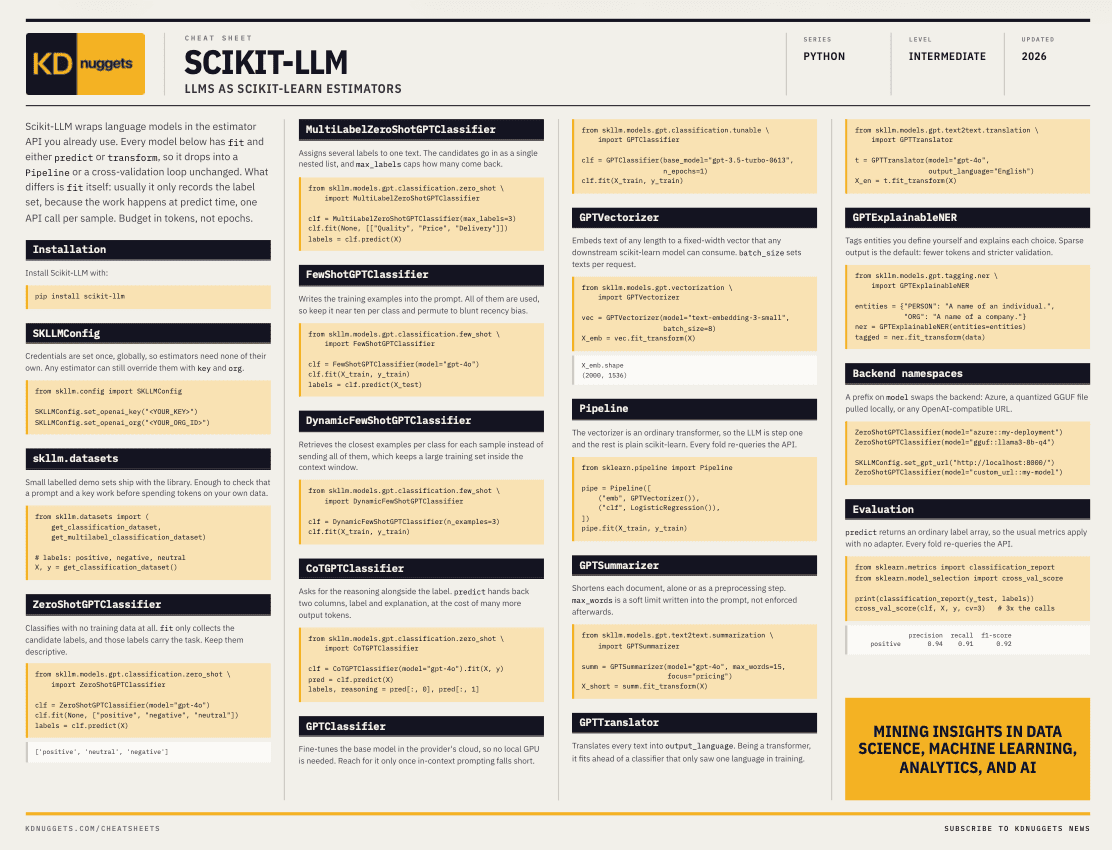
KDnuggets beschrijft hoe Scikit-LLM taalmodellen verpakt in de estimator-API van scikit-learn. Elk model gebruikt fit en predict of transform, zodat het rechtstreeks in een Pipeline of cross-validatielus past. Bij fit worden meestal alleen de labels vastgelegd; de modelaanroep volgt tijdens predict, met één API-call per voorbeeld.
ZeroShotGPTClassifier vormt een belangrijk onderdeel van de cheat sheet. De kandidaatlabels bepalen daar de taak, waardoor vage labels ook vage resultaten opleveren. DynamicFewShotGPTClassifier haalt per voorbeeld de meest gelijkende voorbeelden per klasse op, in plaats van de volledige trainingsset in elke prompt te plaatsen.
Waarom Scikit-LLM ertoe doet
Scikit-LLM biedt een herkenbaar alternatief voor losse scripts met API-loops, tekstverwerking en foutafhandeling. Teams die al met scikit-learn werken, houden hun bestaande denkmodel rond pipelines, classificatie en modelvalidatie vast, terwijl het taalmodel een stap in die keten wordt.
De bibliotheek maakt ook combinaties met klassieke technieken concreet. GPTVectorizer zet tekst van willekeurige lengte om naar vectoren met een vaste breedte. Daarna kan bijvoorbeeld logistic regression op die embeddings volgen. GPTTranslator past als transformer vóór een classifier die alleen Engelse trainingsdata kent, zonder die classifier opnieuw te trainen met een meertalige corpus.
Daar staat een directe kostenpost tegenover. cross_val_score met cv=3 veroorzaakt drie keer zoveel API-calls. Een grid search vermenigvuldigt dat aantal verder. Een evaluatiepatroon dat bij scikit-learn weinig kost, vraagt hier dus expliciete controle.
Concrete takeaway voor Scikit-LLM
Begin met duidelijke, beschrijvende labels bij ZeroShotGPTClassifier en test eerst hoeveel API-calls je pipeline maakt. Controleer daarna cross-validation en grid search afzonderlijk op tokenkosten. Gebruik DynamicFewShotGPTClassifier wanneer gewone few-shot-prompts te weinig context geven, en zet GPTVectorizer in als de rest van de keten met vertrouwde scikit-learn-modellen moet blijven werken. De KDnuggets-cheat sheet dient daarbij als praktische naslag voor de belangrijkste estimators.
Verdiep je kennis
Kennisbank
ETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
KennisbankChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
Gerelateerde artikelen

Scikit-Learn: handige cheat sheet voor feature engineering
Scikit-Learn feature engineering krijgt van KDnuggets een cheat sheet voor preprocessing en modeltuning in Pipelines.

KDnuggets: eerste autonome agent bouwen en 7 belangrijke ML-algoritmes
Wet TTA blijft cruciaal voor de data-industrie na recente wijzigingen.

LLM engineer worden: roadmap voor 2026
LLM engineer worden: roadmap voor 2026 benadrukt de vaardigheden nodig om LLM-applicaties succesvol te implementeren.

Python: 10 bibliotheken voor LLM-applicaties
Python krijgt krachtige bibliotheken voor LLM-applicaties die fine-tuning en modelimplementatie versnellen.