Samenvatting
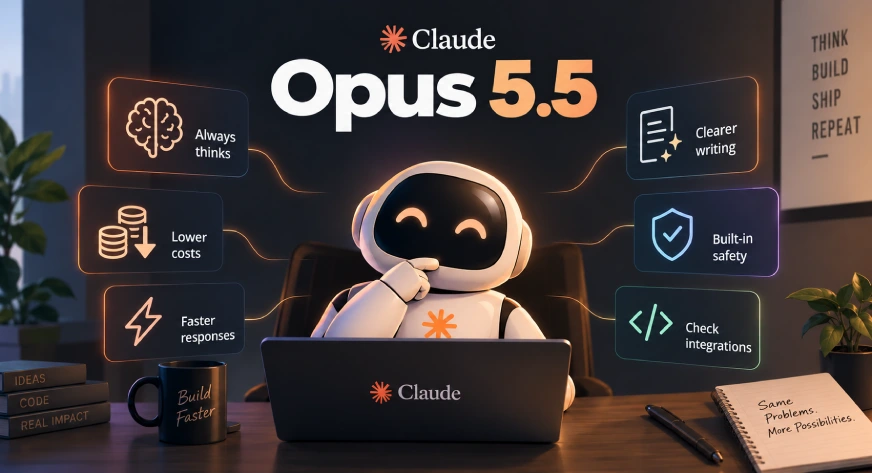
Claude Opus 5.5 redeneert standaard, reageert ruim 30% sneller en verlaagt de kosten per token tegenover Opus 5.
Claude Opus 5.5: wat er gebeurt
Anthropic positioneert Claude Opus 5.5 als het eerste model binnen de Claude 5.5-familie. Het model redeneert bij iedere aanvraag. Gebruikers bepalen de intensiteit via een effort-instelling; medium is de standaard, terwijl Opus 5 standaard op high stond.
De prijs daalt van $5 naar $4 per miljoen inputtokens en van $25 naar $20 per miljoen outputtokens. Cache reads kosten nog $0,20 per miljoen tokens, tegenover $0,50 bij Opus 5. Anthropic meldt daarnaast een uitvoersnelheid die ruim 30% hoger ligt.
De grootste besparing komt volgens de bron niet alleen uit de lagere tokenprijs. Opus 5.5 gebruikt voor taken naar schatting rond 40% minder totale kosten bij typische workloads en standaardinstellingen, doordat het taken met minder tokens afrondt. Dat percentage hangt wel af van het soort workload.
Waarom Claude Opus 5.5 belangrijk is
De wijzigingen raken direct aan de manier waarop teams modelkosten beoordelen. Een lagere prijs per token staat vast, maar de totale rekening hangt ook af van het aantal tokens en de gekozen effort-instelling. Een zware taak kan dus een andere kostenstructuur hebben dan een eenvoudige aanvraag.
Voor ontwikkelaars telt bovendien de hogere outputsnelheid, vooral bij toepassingen met coding agents. De bron beschrijft ook duidelijkere, meer gerichte antwoorden en bespreekt een nieuwe veiligheidslaag. Benchmarks geven een eerste vergelijking met Opus 5, maar drie praktijktests vormen een nuttige aanvulling: een dichte grafiek lezen, rommelige notities omzetten in een update en fouten herkennen.
De combinatie van redeneren bij elke aanvraag en instelbare inspanning maakt kosten en kwaliteit afhankelijk van configuratie. Dat vraagt om testen met eigen prompts en taken, niet alleen om vergelijking van modelnamen.
Concrete takeaway voor Claude Opus 5.5
Leg voor je overstapt een kleine testset aan met representatieve taken. Meet per taak de responstijd, tokengebruik en foutdetectie bij verschillende effort-instellingen. Vergelijk daarna de vaste prijsverlaging met de werkelijke totale kosten van je workload.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen

Praktische tips voor agentic AI-taken bij Claude Cowork
Claude Cowork van Anthropic stelt gebruikers in staat om agentic AI-taken efficiënt uit te voeren zonder constante begel...

Anthropic lanceert Claude Opus 4.7 voor complexe taken
Anthropic lanceert Claude Opus 4.7 die complexe taken vereenvoudigt.
Claude: structuur voor engineer-achtige codeprojecten
Claude biedt een gestructureerde aanpak voor codeprojecten die de kwaliteit van automatisch gegenereerde output verbeter...

Overstappen van ChatGPT naar Claude zonder context of geheugen te verliezen
Gebruikers kunnen nu eenvoudig overschakelen van ChatGPT naar Claude zonder context of geheugen te verliezen, wat de fle...