Samenvatting
Databricks draait open-Jev-modellen via SQL op governed data, met serverless GPU’s en beheerde Model Serving-endpoints.
Databricks en open-Jev: wat er gebeurt
Databricks laat modellen zoals SemIf-OpenJev rechtstreeks werken op data binnen het platform. Serverless GPU’s leveren de rekenkracht, terwijl Managed Model Serving het model beschikbaar maakt via een beheerd endpoint.
Een importeerbaar Databricks Notebook automatiseert de start: kies de modelnaam en het schema, selecteer Serverless GPU en klik op Run All. Het notebook downloadt de modelbestanden, registreert het model met Express Deployments en maakt automatisch een GPU Model Serving-endpoint aan.
Databricks ai_query en SQL: waarom dit belangrijk is
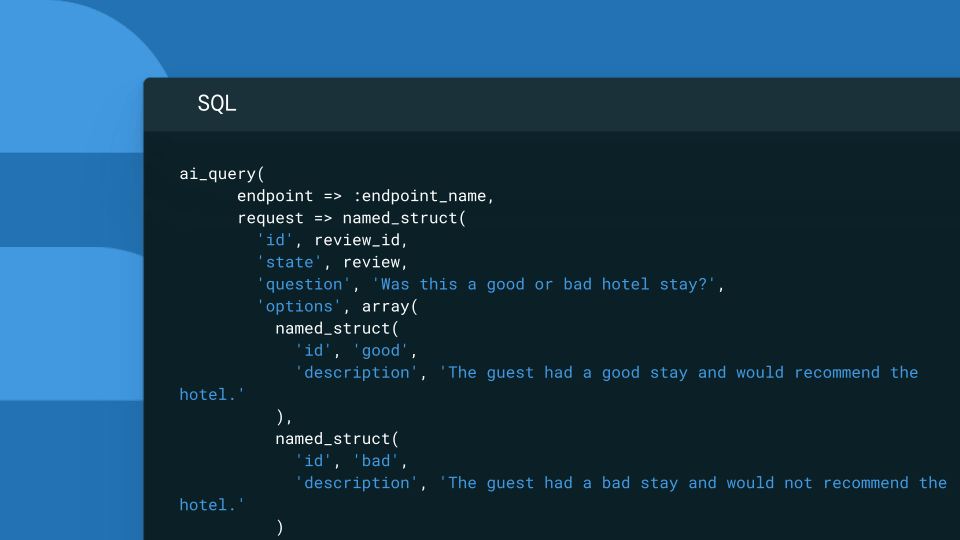
Met ai_query roep je een aangepast model-endpoint direct aan vanuit SQL of vanuit Lakeflow-jobs. Dat endpoint hoeft geen standaard chat-completionsinterface te gebruiken. SemIf-OpenJev accepteert zijn eigen gestructureerde aanvraagformaat en geeft een classificatie plus waarschijnlijkheden voor de opties terug als gestructureerde kolommen.
Het voorbeeld gebruikt hotelreviews en deelt die in als goed of slecht. Daarmee blijft de analyse dicht bij de data die al in Databricks staat. AI Runtime levert serverless, on-demand GPU-compute en ondersteunt het aanpassen of post-trainen van modellen voor een specifieke context.
Open gewicht-modellen zoals Smelf-open-jev, Laya en Kev laten zien dat SemIf-OpenJev niet de enige route is. Het verschil zit vervolgens niet alleen in het model, maar ook in de manier waarop je het model registreert, serveert en vanuit SQL aanroept.
Databricks: concrete takeaway
Importeer het notebook in je Databricks-workspace en test eerst SemIf-OpenJev met Serverless GPU en Run All. Controleer daarna het aanvraagformaat, de classificatiekolommen en de teruggegeven optieprobabiliteiten voordat je het model op eigen gegevens toepast. Leg vooraf vast welke beslissingen het model mag nemen en pas het schema en de besliscriteria daarop aan. Lakeflow-jobs en ai_query vormen daarbij de route van een notebooktest naar een terugkerende SQL- of productieaanroep.
Verdiep je kennis
Kennisbank
ETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
KennisbankData lakehouse uitgelegd — Het beste van twee werelden
Wat is een data lakehouse en waarom combineert het het beste van data warehouses en data lakes? Vergelijking, architectu...
KennisbankWat is Business Intelligence? Uitleg, voorbeelden en tools
Wat is business intelligence (BI)? Leer over de definitie, de BI-stack, praktijkvoorbeelden, populaire tools en de trend...
Gerelateerde artikelen

Agentic code converter: converteer code naar open ANSI SQL
Agentic code converter: converteert code naar open ANSI SQL voor eenvoudige migraties.
Genie Code: converteer code naar open ANSI SQL
Databricks lanceert Genie Code om eigen SQL naar open ANSI SQL te converteren.

Fizz versnelt e-commerce-analyse met Databricks SQL
Fizz heeft zijn e-commerce-analyse aanzienlijk verbeterd door gebruik te maken van Databricks SQL, wat leidt tot sneller...

SQL Alerts: automatiseer data- en KPI-monitoring
SQL Alerts automatiseert data- en KPI-monitoring waardoor handmatige taken worden verminderd.