Samenvatting
SLM-optimalisatie profiteert van batching op tokenlengte, omdat vergelijkbare sequenties padding en herhaalde gewichtslezingen beperken.
SLM-optimalisatie met batching op lengte
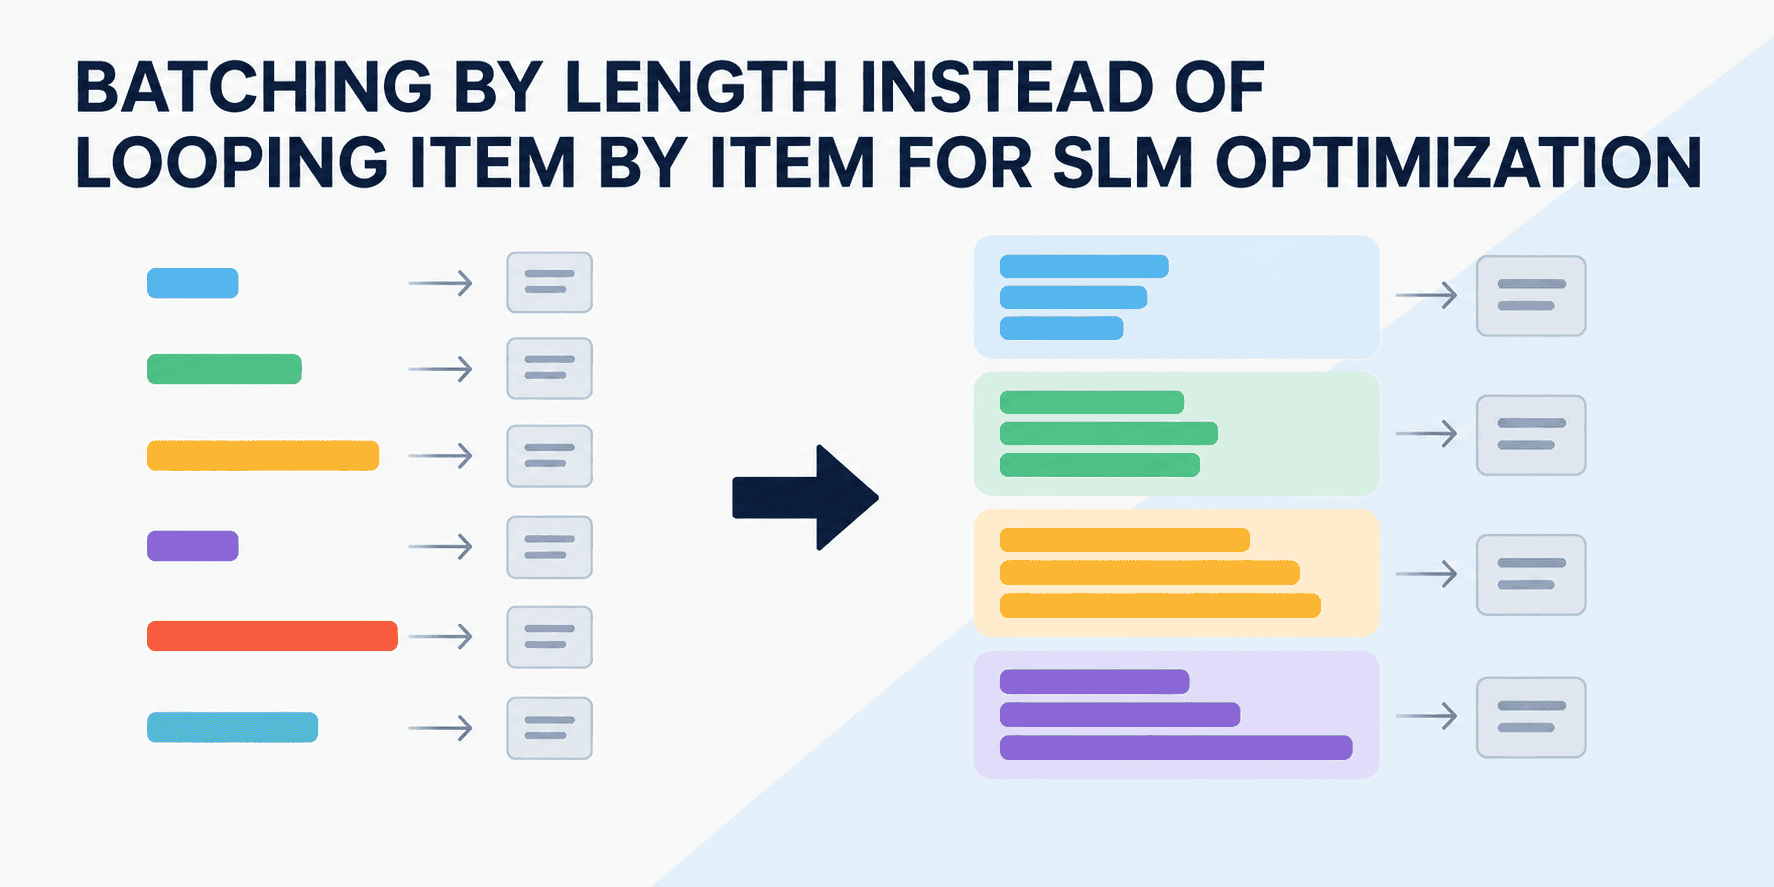
KDnuggets sluit een korte reeks over SLM-optimalisatie af met batching op lengte in plaats van verwerking van items één voor één. De aanpak sorteert invoer op tokenlengte en vormt daarna batches met items van vergelijkbare omvang. Daardoor vult elke batch alleen aan tot zijn eigen lokale maximum, in plaats van tot de lengte van het langste item in de volledige dataset.
De voorbeelden gebruiken Qwen2.5-0.5B-Instruct via Hugging Face Transformers op een MacBook Air met een M2-chip, 24 GB RAM en een 16-core Neural Engine. Het artikel werkt met supporttickets en gebruikt beperkte classificatiescores voor billing, technical en account.
Waarom batching op tokenlengte telt
Bij batchgrootte 1 leest het model zijn gewichten voor elke sequentie opnieuw uit het geheugen. De rekenkernen wachten daardoor grotendeels, terwijl de geheugenbandbreedte de verwerking begrenst. Batching verdeelt die gewichtslezing over meerdere sequenties, zowel op een GPU als op de CPU waarop een model van 0,5 miljard parameters vaak draait.
Een gewone batch lost dat probleem niet volledig op. Teksten verschillen sterk in lengte: een dataset kan items van enkele honderden tokens bevatten, terwijl de mediaan ruim onder honderd tokens ligt. Globale padding rekent dan veel lege posities mee. Sorteren op tokenlengte vormt het praktische alternatief voor de bestaande één-voor-één-lus en beperkt die verspilling zonder het classificatiemodel te wijzigen.
Concrete takeaway voor SLM-optimalisatie
Pas bij een SLM-pipeline eerst length sorting en lokale padding toe voordat je conclusies trekt uit batchmetingen. Leg daarbij dezelfde forward-passlogica en labelbeperking vast als in de nulmeting, zodat alleen de batchindeling verandert. Controleer vervolgens afzonderlijk het geheugengebruik en de verwerkingstijd op jouw hardware; de bronbenchmarks gebruiken een specifieke M2-configuratie en zijn niet automatisch representatief voor andere systemen.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen

Prompt Prefix hergebruiken met Key-Value Cache voor SLM
Key-Value Cache hergebruikt vaste promptdelen en verkleint zo de pre-fill per supportticket.

Resultaten ruimte beperken voor SLM optimalisatie
SLM optimalisatie: beperkte uitgifte ruimtetechniek verbetert automatisch processen.

Polars: alternatieve prestatieanalyse in plaats van Pandas
Power BI krijgt concurrentie van Polars, een nieuwere DataFrame-bibliotheek die performance aanzienlijk verbetert.

Stop met if-else ketens: gebruik registry patroon in Python
Registry patroon biedt beter alternatief voor inefficiënte if-else ketens in Python.