Samenvatting
Sarvam Vision 2.1 leest Indische talen en Engelse documenten en koppelt OCR aan structuurherkenning in tabellen, formulieren en handschrift.
Sarvam Vision 2.1 combineert OCR en documentstructuur
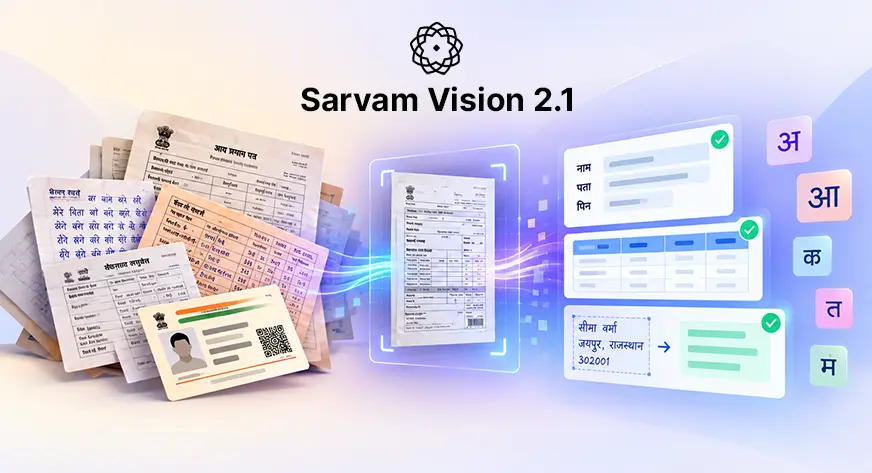
Sarvam Vision 2.1 richt zich op documenten waarin tekstherkenning niet genoeg is. Het model haalt bijvoorbeeld een waarde uit een tabel samen met de bijbehorende rij- en kolomkoppen, koppelt labels aan velden op formulieren en zet handgeschreven tekst in Indische schriften om naar gestructureerde velden.
Volgens de beschreven benchmarks doorbreekt het model daarmee een scheiding tussen Engelse documentanalyse en herkenning van Indische talen. Infinity-Parser2 Pro scoort 86,1 op Engelse documentstructuur, maar 49,83 op Indic-documenten. Google Cloud Vision haalt 39,6 op Engelse structuur en 71,76 op Indische talen. Sarvam Vision 2.1 is in de vergelijking het enige model in de hoek die beide dimensies combineert.
Waarom Sarvam Vision 2.1 relevant is voor documentautomatisering
De toepassing ligt bij documenten waarin layout en taal samen de betekenis bepalen. Denk aan facturen, financiële overzichten, verzekeringsclaims en regionale archieven. Vooral handschrift vormt een zware test: Sarvam trainde dit onderdeel deels met videobronnen om variatie in echte handschriften mee te nemen, in plaats van alleen synthetische voorbeelden.
Sarvam publiceerde daarnaast een eigen Indic-benchmark met 6.909 voorbeelden. Daarvan bestrijken 6.609 voorbeelden alle 22 officiële Indiase talen en komen 300 voorbeelden uit het Engels. De dataset bevat kranten, brochures, schoolboeken en historische teksten uit de periode van 1800 tot het heden. Publicatie op Hugging Face maakt controle door anderen mogelijk, al blijft vergelijking met onafhankelijke tests nodig.
Concrete takeaway voor Sarvam Vision 2.1
Test Sarvam Vision 2.1 met vijf eigen documenten: minstens één tabel, formulier en handgeschreven document in de talen die je verwerkt. Vergelijk niet alleen transcriptie, maar ook de koppeling tussen waarden, labels en documentvelden. Gebruik de openbare benchmark om de uitkomsten naast de prestaties van Google Cloud Vision en andere modellen te leggen.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen
GPT-6 Astra: nieuwe ontwikkelingen in OpenAI's model
GPT-6 Astra haalt 72,6% op OSWorld 2.0 en voert computertaken uit in plaats van alleen instructies te geven.

Sarvam Edge: een beginnersgids voor on-device AI in India
Sarvam Edge brengt on-device AI naar India: werkt offline, spreekt lokale talen en beschermt privacy op het apparaat.

ChatGPT en Claude: De AI-modellenstrijd van 2026
De strijd tussen ChatGPT en Claude in 2026 zal bepalen welke AI-modellen de toekomst van business intelligence vormgeven...

Mistral Small 4: Eén model voor coderen, redeneren en chatten
Mistral Small 4 is een nieuwe AI-oplossing die coderen, redeneren en chatten integreert in één krachtig model.