Samenvatting
Tokencompressie verlaagt het aantal tokens in LLM-prompts zonder de kwaliteit van antwoorden op te offeren.
Wat tokencompressie en promptoptimalisatie doen
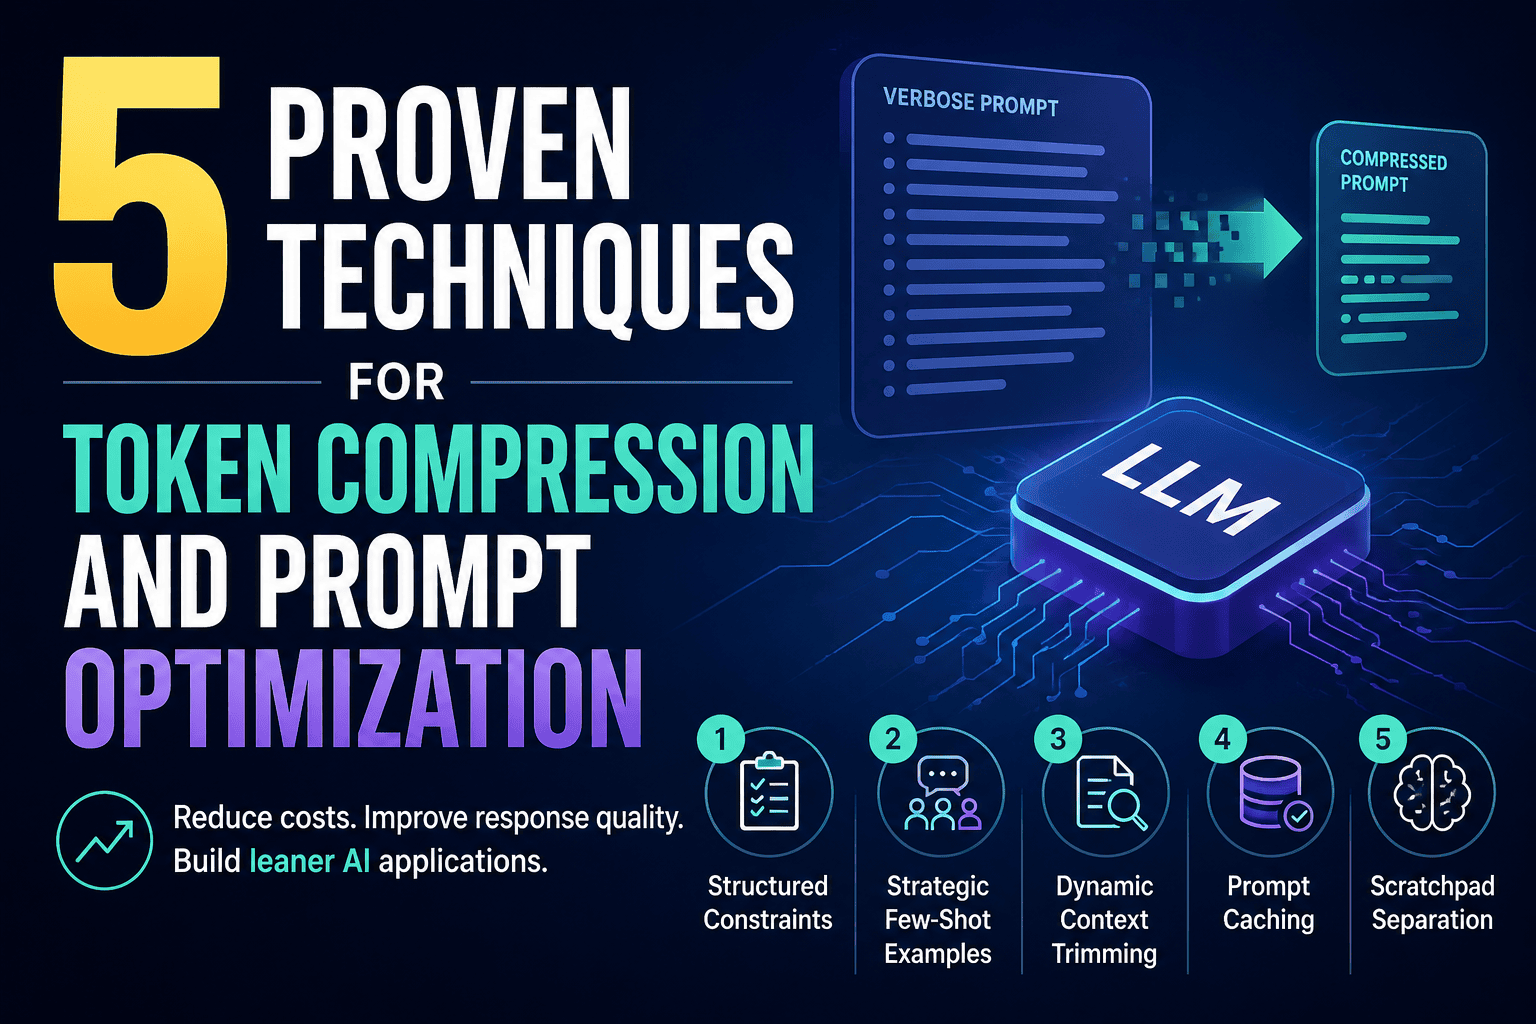
KDnuggets beschrijft vijf technieken om prompts compacter te maken en LLM-toepassingen goedkoper en consistenter te laten werken. De aanpak richt zich op het schrappen van overbodige instructies, terwijl de bedoeling van de prompt behouden blijft.
De eerste techniek vervangt lange, gesprekachtige instructies door gestructureerde beperkingen. Een instructie van 36 tokens kan volgens het artikel worden teruggebracht tot ongeveer 14 tokens met pipe-gescheiden sleutel-waardeparen, YAML-achtige regels of JSON-schemafragmenten. Bij duizenden API-aanroepen stapelt die besparing zich op.
De tweede techniek gebruikt few-shot voorbeelden selectief. Drie voorbeelden kunnen het gewenste uitvoerformaat vastleggen; meer voorbeelden leveren volgens aangehaalde onderzoeken en benchmarks vaak minder extra kwaliteit op. Het artikel adviseert prompts met één, drie en vijf voorbeelden te testen.
Waarom tokencompressie belangrijk is
Elke token verhoogt het verbruik van een LLM-toepassing. Lange prompts belasten niet alleen budgetten, maar kunnen ook de antwoordkwaliteit verminderen doordat irrelevante instructies en context de kernboodschap verdringen.
Dat speelt bij productieapplicaties, notebookexperimenten en toepassingen die lange documenten verwerken. De derde beschreven techniek, dynamisch context inkorten, haalt alleen relevante passages uit transcripties, juridische teksten of kennisbankartikelen. De methode voorkomt dat een model telkens een volledig document ontvangt.
De aanpak vraagt om een andere manier van promptontwerp: niet meer tekst toevoegen om een model te sturen, maar instructies structureren en context gericht selecteren.
Concrete takeaway voor tokencompressie
Controleer bestaande prompts op drie punten: vervang verhalende instructies door compacte constraints, test few-shot prompts met één, drie en vijf voorbeelden en trim lange documenten voordat ze naar het model gaan. Meet daarbij zowel tokenverbruik als antwoordkwaliteit, zodat een kortere prompt niet ongemerkt informatie verliest.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen
Overzicht van het State of Agent Engineering-rapport
De nieuwste inzichten uit het State of Agent Engineering-rapport bieden BI-professionals een waardevolle kijk op de ontw...
OpenClaw Uitleg: De Gratis AI Agent Tool die Al Viral Gaat in 2026
OpenClaw is een innovatieve gratis AI-agent tool met meer dan 100 ingebouwde vaardigheden die razendsnel viraal gaat in ...
Abacus AI: eerlijke beoordeling en prijs, vervangt 10+ tools?
Abacus AI biedt een alles-in-één platform dat tien of meer tools vervangt, waardoor BI-professionals sneller toepassinge...
Top 7 AI Agent Orkestratiefraaien
De opkomst van AI-agent orkestratiefraaien biedt nieuwe mogelijkheden voor het bouwen van autonome systemen.