Samenvatting
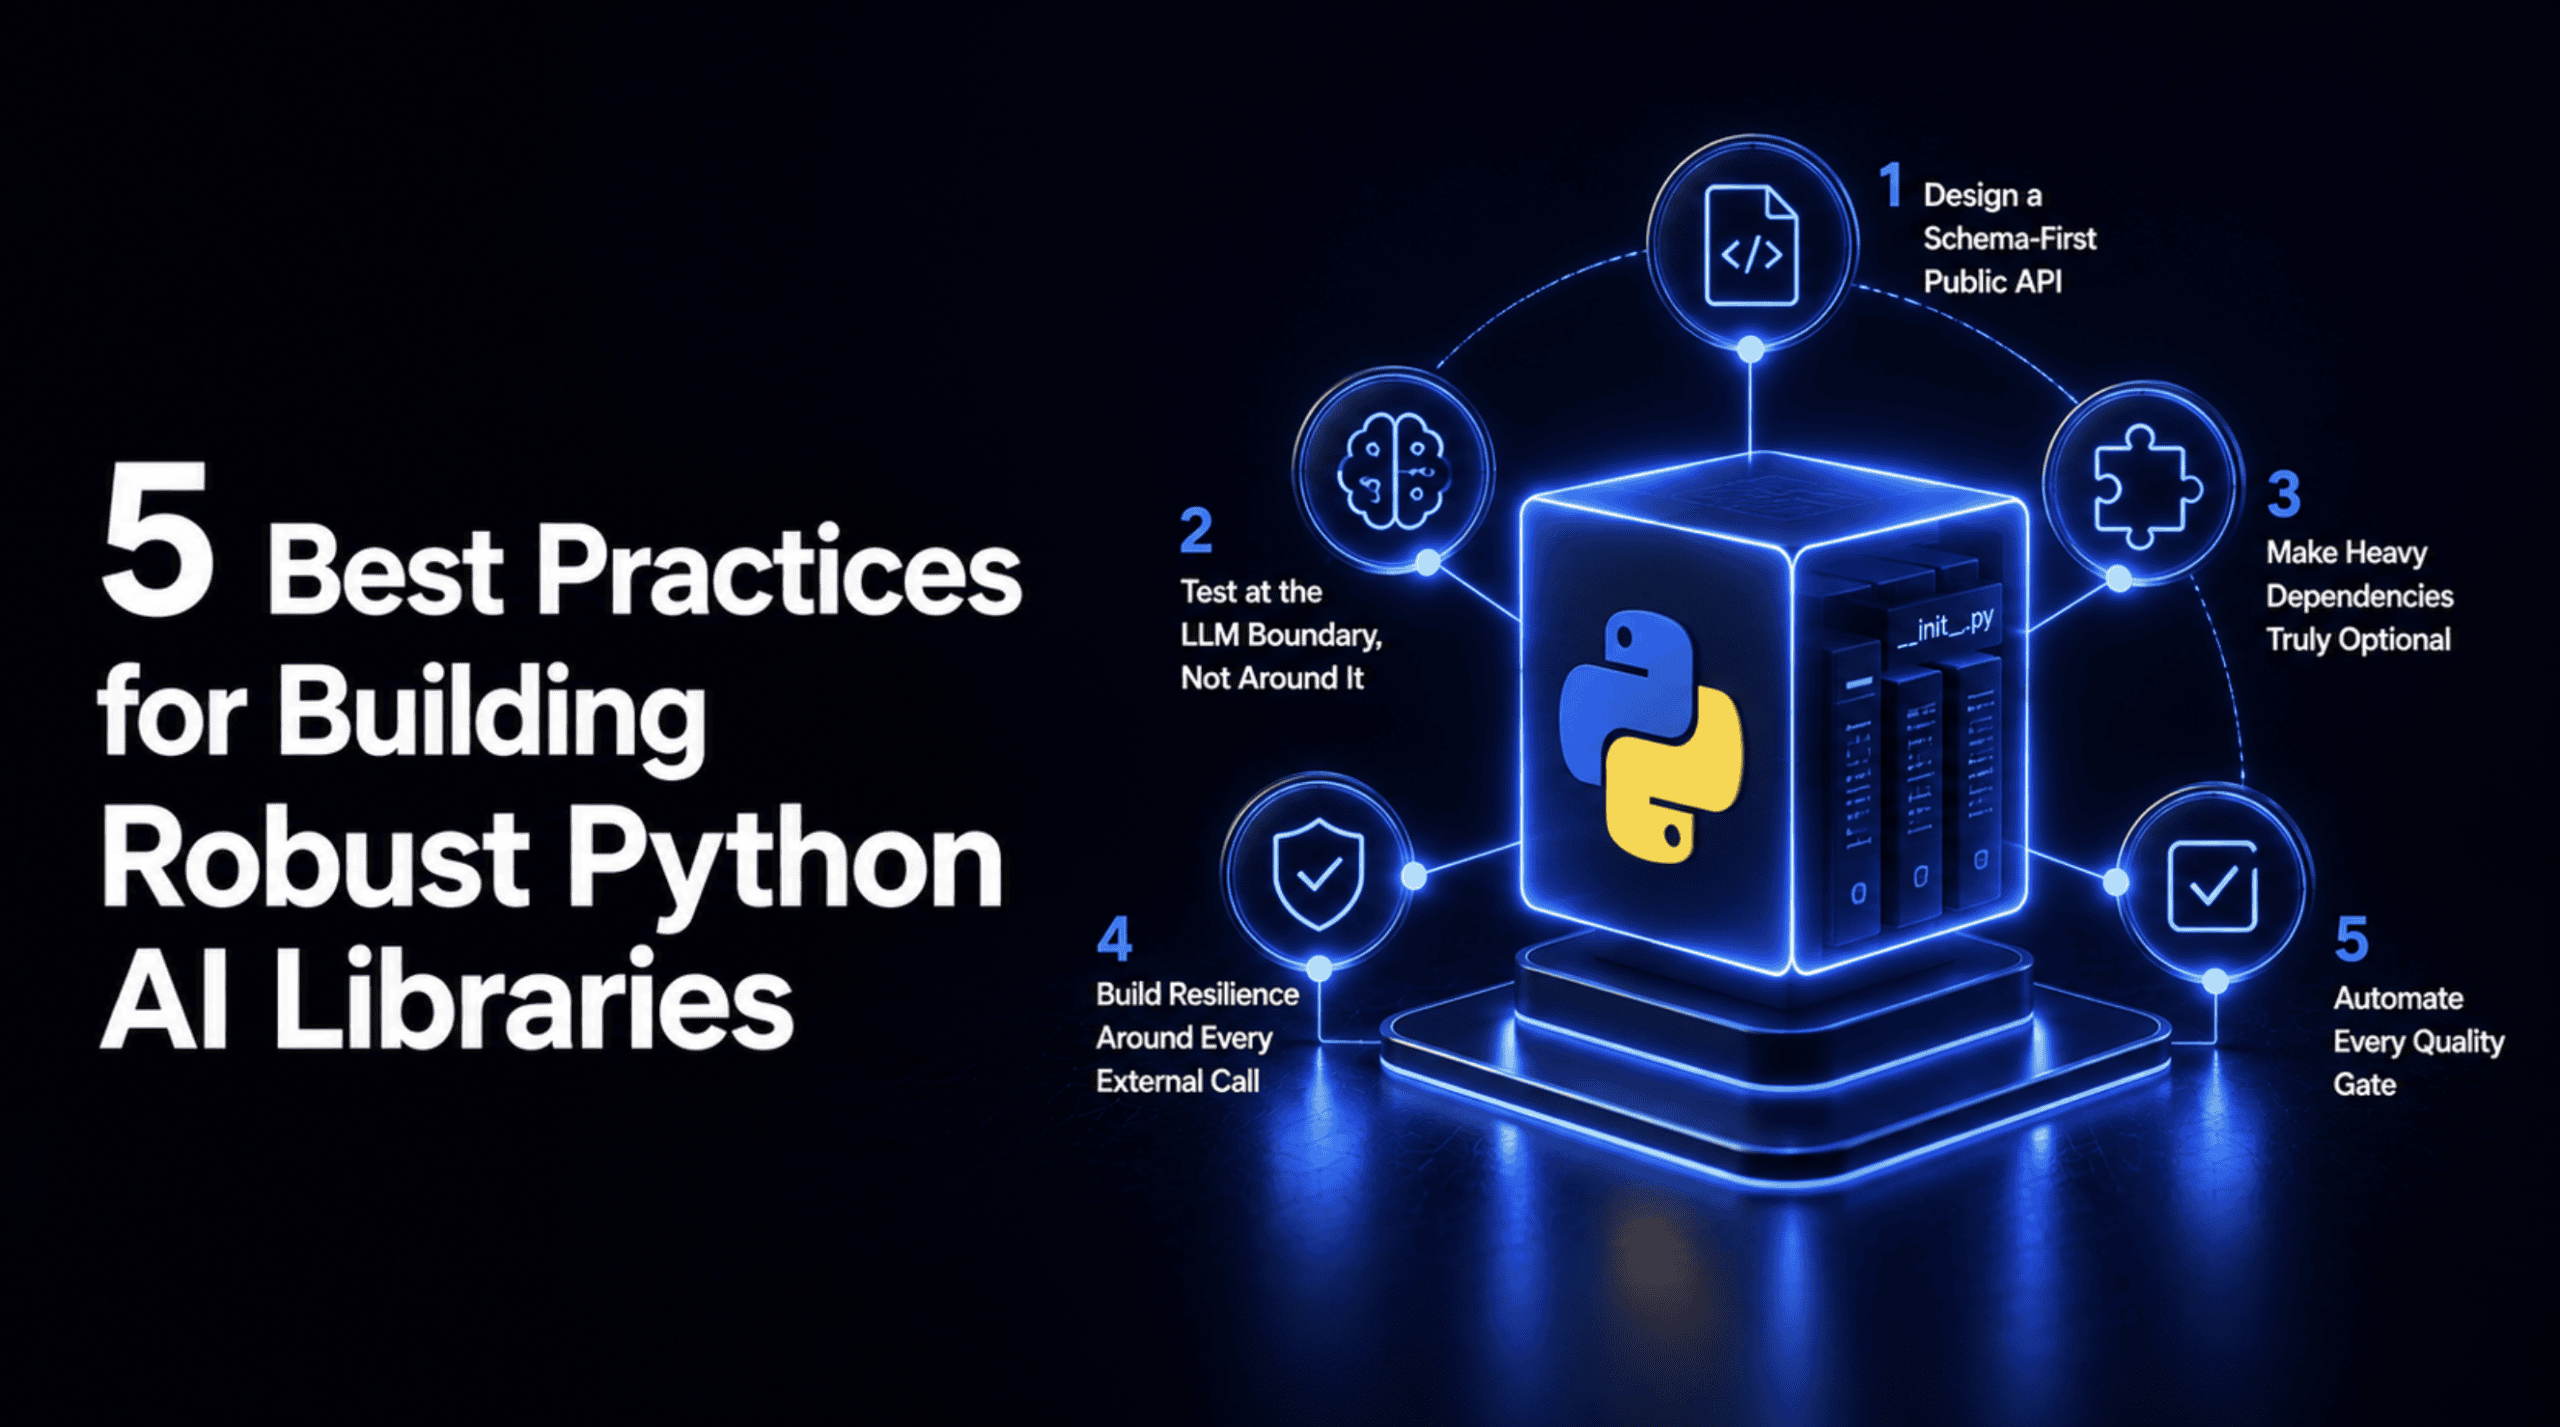
Python AI-libraries vragen om vijf werkwijzen voor pakketten die buiten de demo betrouwbaar blijven.
Python AI-libraries: vijf werkwijzen
Het artikel beschrijft hoe je Python AI-libraries bouwt die ook bij andere gebruikers en in productie blijven werken. De voorbeelden draaien rond één samenhangende bibliotheek en behandelen onder meer packaging, testen, foutafhandeling en afhankelijkheden.
De aanleiding is herkenbaar: een ontbrekende API-sleutel kan eindigen in een onduidelijke KeyError, een eenvoudige tekstclassificatiefunctie kan ongemerkt een deep-learningframework van vier gigabyte installeren en tests kunnen falen zodra een modelprovider anders formuleert. Dat zijn geen gewone programmeerfouten, maar specifieke risico’s van AI-software.
Waarom robuuste Python AI-libraries tellen
AI-libraries verschillen van pakketten die alleen een database aanspreken of bestanden verwerken. Modeluitvoer volgt niet gegarandeerd een schema, externe API’s falen op uiteenlopende manieren en afhankelijkheden kunnen zwaar uitvallen. Daardoor moet een bibliotheek haar eigen logica duidelijk scheiden van gedrag van modellen en leveranciers.
De voorgestelde basis bestaat uit volledige type-informatie, inclusief een py.typed-marker, en een pyproject.toml-structuur volgens PEP 621. Daarnaast moeten publieke functies invoer en uitvoer controleren in plaats van modelresultaten blind te vertrouwen. Optionele afhankelijkheden houden een installatie beperkt tot wat een gebruiker werkelijk nodig heeft. Pytest helpt vervolgens om de bibliotheeklogica te testen zonder iedere keer de exacte formulering van een model te eisen.
Concrete takeaway voor Python AI-libraries
Behandel een AI-bibliotheek niet als een gewone REST-wrapper. Leg eerst vast welke invoer, uitvoer en fouten je pakket zelf beheert; isoleer zware afhankelijkheden; voeg volledige type-informatie toe; en test externe modelaanroepen met stabiele controles op de eigen logica. Controleer daarbij expliciet hoe de bibliotheek reageert op ontbrekende API-sleutels en afwijkende modeluitvoer.
Verdiep je kennis
Kennisbank
Dashboard design — 7 regels voor effectieve datavisualisatie
Leer de 7 gouden regels voor effectief dashboard design. Van het kiezen van het juiste grafiektype tot visuele hiërarchi...
KennisbankETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
KennisbankData governance in het MKB — Praktische aanpak
Wat is data governance en hoe pak je het aan als MKB-organisatie? Een praktisch stappenplan met aandacht voor AVG-compli...
Gerelateerde artikelen

Python: zeven best practices voor senior ontwikkelaars
Python krijgt zeven best practices die senior ontwikkelaars gebruiken om verrassingen vóór productie zichtbaar te maken.

Python: zeven fouten van beginners en oplossingen
Python-fouten door beginners veroorzaken vaak onbegrijpelijke problemen zonder duidelijke foutmeldingen.

Python: handige tips voor dictionary-gebruik
Python-dictionaries: kortere, veiliger en leesbare code met 7 onmisbare tips.

Python: zeven veelvoorkomende fouten in AI-workflows
Python: veelgemaakte fouten in AI-workflows veroorzaken stille bugs.