Samenvatting
Databricks laat zien hoe IFCO een groot dbt-project ruim 60 procent sneller draait zonder nachtelijke full refresh.
Databricks en dbt: wat er gebeurt
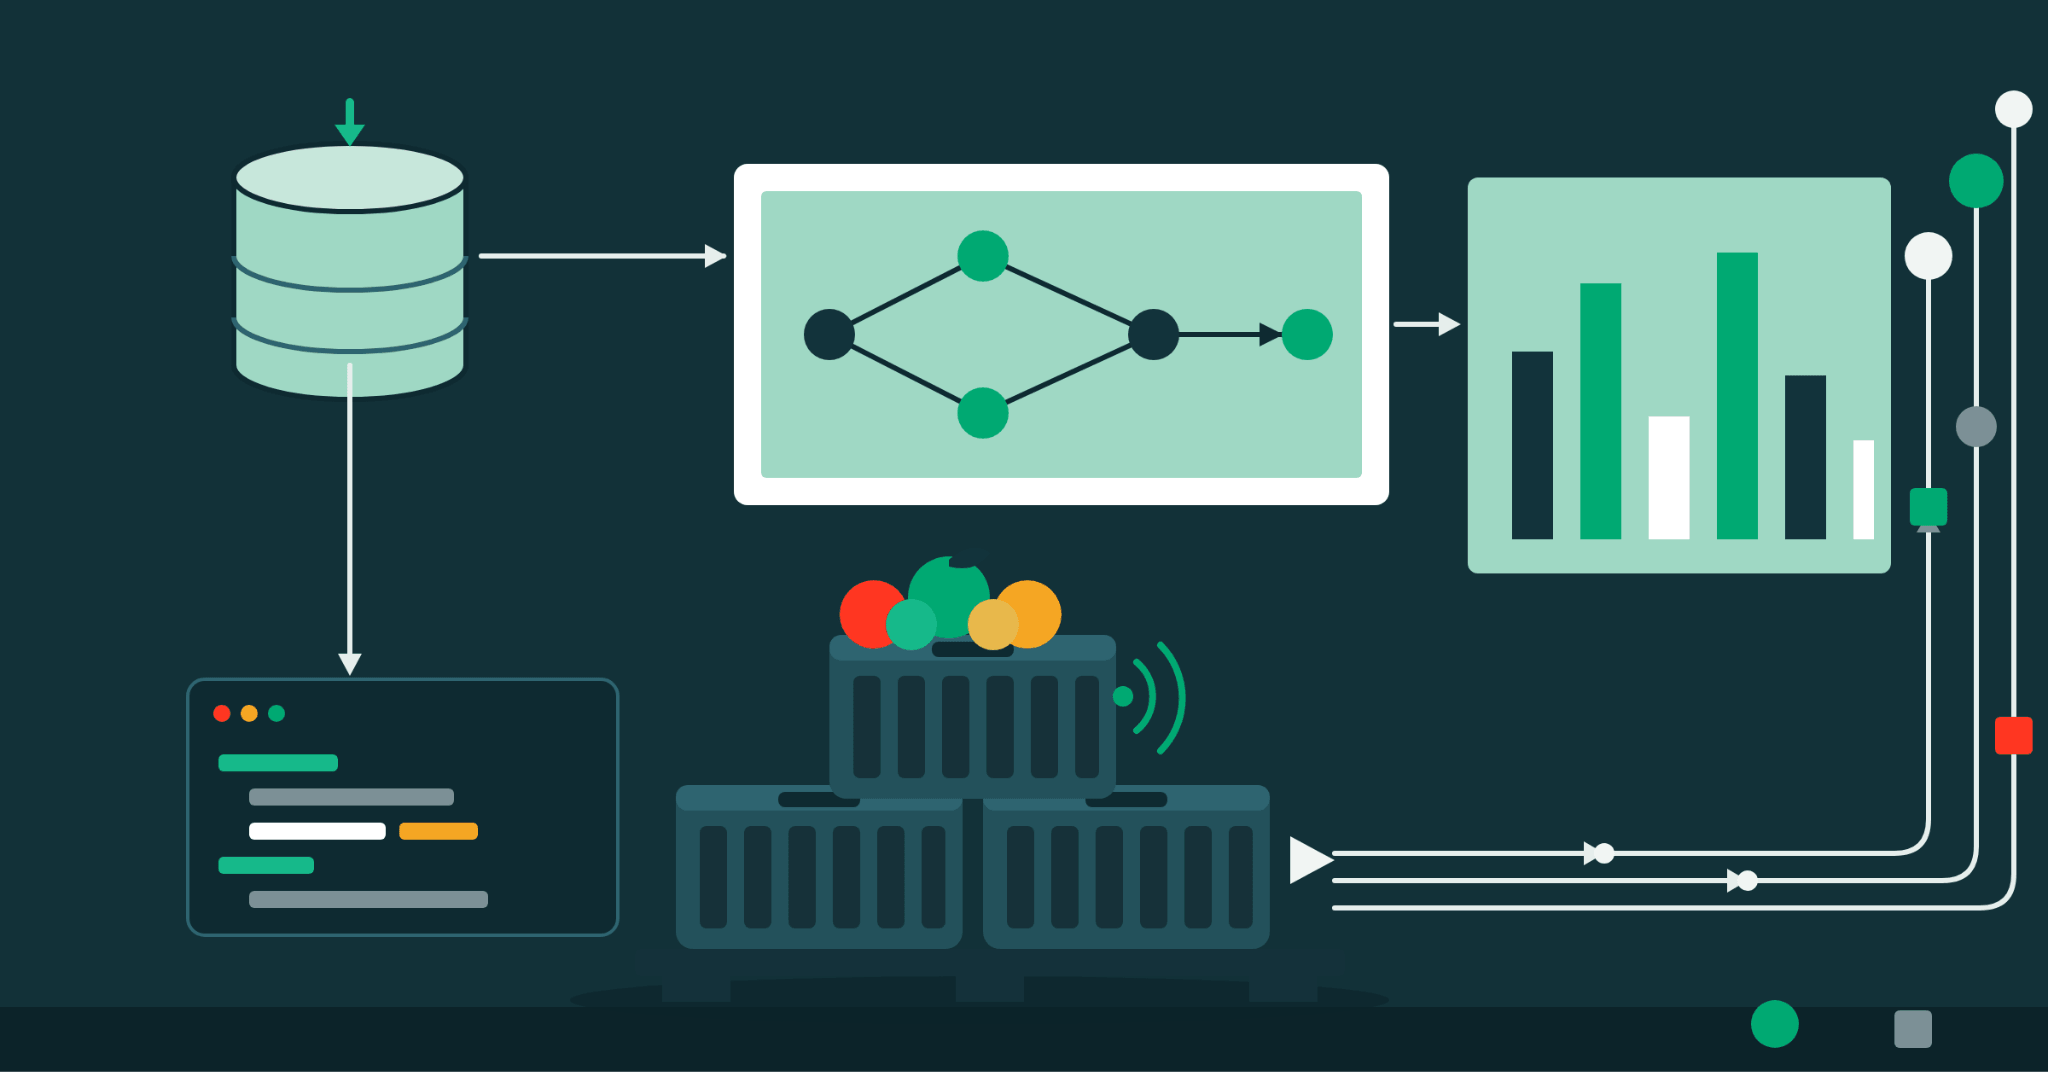
IFCO verwerkt miljarden trackingevents per dag voor KPI’s rond cyclustijd, verlies, schade, waskosten en poolomvang. Het team houdt de transformatielogica in dbt en voert die uit op Databricks. Door incremental models alleen gewijzigde rijen te laten schrijven, liquid clustering, een gerichte merge-strategie en dynamic file pruning daalde de dagelijkse runtime van de kernjob met ruim 60 procent.
Die aanpak maakte een nachtelijke volledige refresh overbodig. Voor trage modellen kijkt IFCO naar het werkelijk uitgevoerde queryplan, niet alleen naar de gecompileerde SQL. Het team verpakte die diagnose in een herhaalbare skill die op elk model draait.
Waarom Databricks en dbt ertoe doen
De casus laat zien dat dbt-instellingen op Databricks direct doorwerken in Delta Lake-schrijfbewerkingen. De gekozen datagranulariteit bepaalt onder meer welke kolommen clusteren, hoeveel van een doeltabel een schrijfactie raakt en of Databricks rijen samenvoegt of vervangt.
Ook de taakindeling maakt verschil. IFCO draait het dbt-project via Databricks Jobs als één taak per model, met de open-source databricks-dbt-factory. Daardoor ziet het team per model wat er gebeurt, kan het gerichte reruns uitvoeren en tests afdwingen. Dat contrasteert met één ondoorzichtige job, waarbij fouten en trage onderdelen lastiger te isoleren zijn.
De technische aanpak sluit aan op IFCO’s dataprobleem: assets keren herhaaldelijk terug, signalen komen via barcodes, RFID en trackers binnen en late gebeurtenissen kunnen eerder gerapporteerde historie corrigeren.
Concrete takeaway
Koppel elke dbt-incrementalinstelling aan het fysieke gedrag in Databricks en Delta Lake. Splits daarnaast Databricks Jobs per model op, controleer het echte queryplan en automatiseer die controle; zo vind je precies welk model runtime en herstelwerk veroorzaakt.
Verdiep je kennis
Kennisbank
Data lakehouse uitgelegd — Het beste van twee werelden
Wat is een data lakehouse en waarom combineert het het beste van data warehouses en data lakes? Vergelijking, architectu...
KennisbankETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
KennisbankData-driven werken — Hoe begin je als organisatie?
Leer hoe je als organisatie data-driven gaat werken. Van data-volwassenheid tot cultuurverandering: een praktisch stappe...
Gerelateerde artikelen

Google Cloud Use Cases: Data en AI draaien op GCP met Databricks
Google Cloud biedt vernieuwende oplossingen voor enterprises met Databricks, waardoor data en AI efficiënt op GCP kunnen...
Lovable + Databricks: datagedreven apps snel bouwen
Lovable en Databricks versnellen het bouwen van datagedreven applicaties door low-code development met enterprise data t...
Databricks: waarom dbt snelle integratie mogelijk maakt
Databricks biedt integratie met dbt die datatransformatieprocessen versnelt en de workflow optimaliseert.
Databricks: nieuw ecosysteem voor databeheer binnen bedrijven
Databricks: nieuw opslagecosysteem verbetert datagovernance voor bedrijfsomgevingen.