Samenvatting
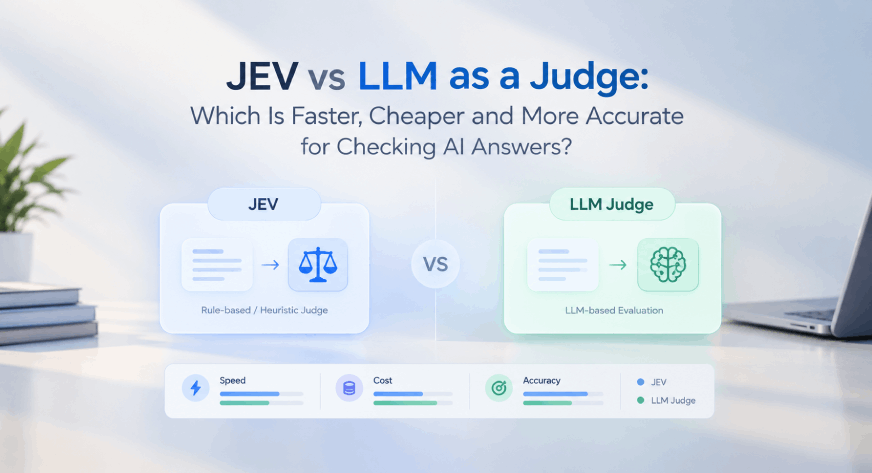
JEV vs LLM vergelijkt twee manieren om AI-antwoorden te beoordelen: een korte keuze met confidence tegenover tekstuele uitleg.
JEV versus LLM als beoordelaar
LLM-as-a-Judge controleert AI-antwoorden met een taalmodel dat zijn oordeel meestal als tekst schrijft. Dat werkt bij lange of open antwoorden, maar elke beoordeling brengt extra kosten, vertraging en mogelijke bias mee.
JEV, een klein beslismodel van TypeSafe AI, kiest een kort antwoord uit een opgegeven lijst en geeft probabilities mee. Het model kan ook een score geven, zoals laag, gemiddeld of hoog, of de kans berekenen dat een ja-neestelling waar is. JEV schrijft geen uitleg bij zijn oordeel.
De auteur benadrukt dat JEV niet open is en dat claims van TypeSafe AI over de confidence-scores niet onafhankelijk konden worden gecontroleerd. Daarom test het artikel JEV met eigen gegevens, naast een LLM-beoordelaar.
Waarom JEV en LLM-beoordelaars belangrijk zijn
De vergelijking draait niet alleen om nauwkeurigheid. JEV past bij eenvoudige, herhaalde controles waarbij het bewijs in de tekst staat, bijvoorbeeld de vraag of een antwoord op een document steunt. Een LLM-beoordelaar past beter bij open vragen, complexe redeneringen en schriftelijke feedback.
Het CMU-onderzoek bespreekt een gemiddelde nauwkeurigheid tegen zeer lage kosten, maar laat ook grenzen zien. JEV presteert zwakker wanneer het antwoord eerst moet worden afgeleid. Sommige taken blijken voor beide beoordelaars lastig. De confidence-score is daarom een afzonderlijk onderdeel van de beoordeling: JEV kan aangeven wanneer het onzeker is.
Langfuse ondersteunt JEV naast LLM-beoordelaars en code-based checks. Daarmee ontstaat geen keuze tussen één universele beoordelaar, maar een combinatie van controles per taak.
Concrete takeaway
Test JEV eerst op je eigen evaluatieset en splits controles op naar type. Gebruik een confidence-drempel uit die gegevens, laat onzekere gevallen door een LLM-beoordelaar controleren en gebruik code-based checks waar een exacte regel volstaat.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen
JEV: nieuwe controlefunctie voor LLM's
JEV controleert meerdere LLM-antwoorden op bronsteun en stuurt onzekere gevallen door naar een groter model.
Claude Code: gedetailleerde vergelijking met Codex
Claude Code biedt een uniforme agent-loop die de samenwerking tussen omgevingen verbetert en de efficiëntie van ontwikke...
AI: top 10 LLM-onderzoekspapers van 2026
AI-onderzoeksfocus verandert met LLM-onderzoek in 2026 dat modellen veiliger, controleerbaarder en nuttiger maakt.

AI-geheugenlagen: van Karpathy’s LLM Wiki naar Graphify
De introductie van AI-geheugenlagen belooft een revolutie in de efficiëntie van AI-workflows door context te behouden.