Samenvatting
Databricks maakt multi-statementtransacties algemeen beschikbaar voor Lakehouse-workloads op Delta Lake en Apache Iceberg.
Databricks-transacties voor Lakehouse-warehousing
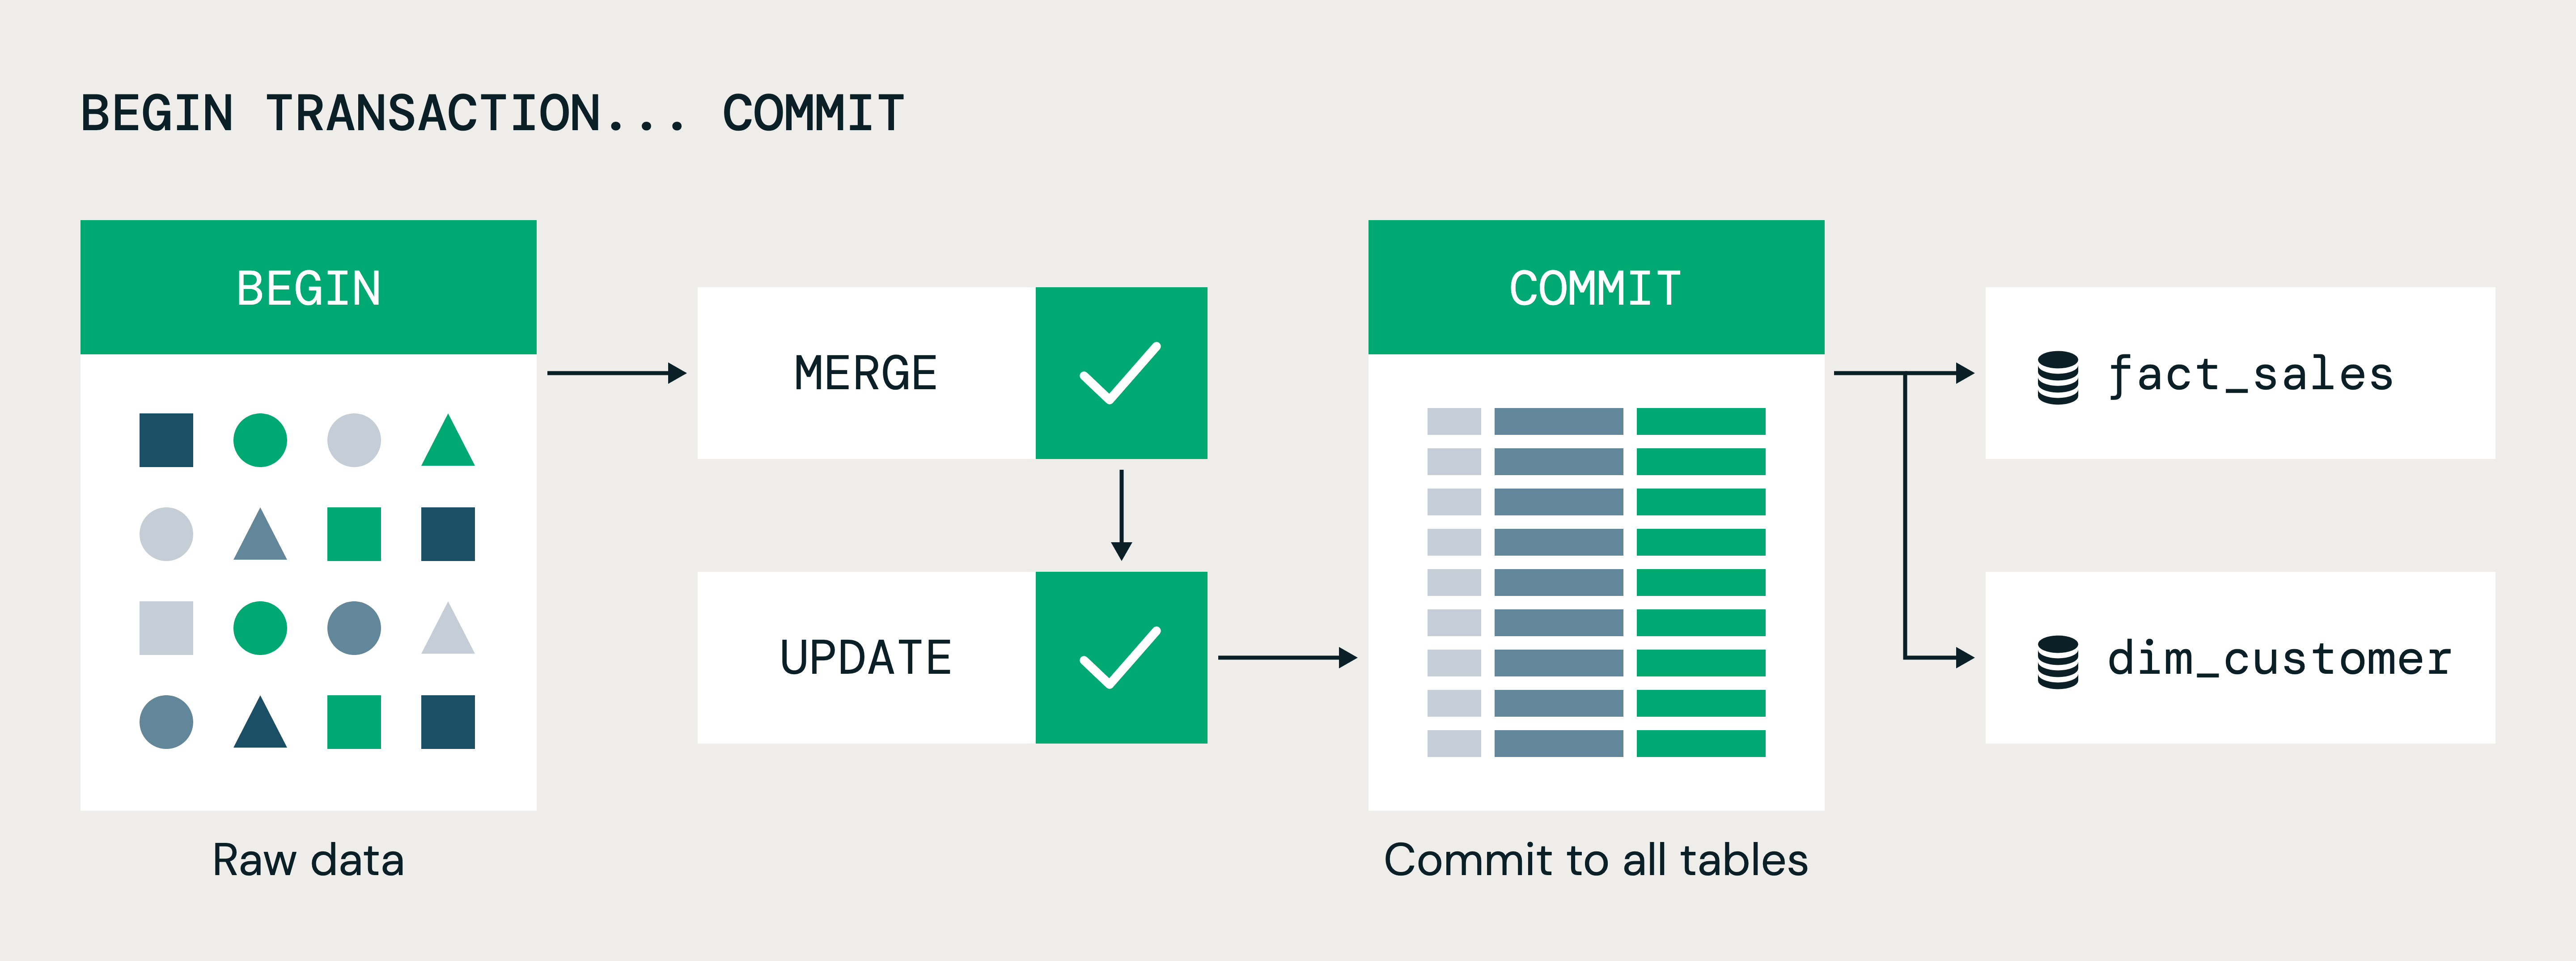
Databricks stelt multi-statementtransacties algemeen beschikbaar. Daarmee kunnen meerdere SQL-statements en wijzigingen in verschillende tabellen atomair slagen of falen, zonder aparte warehouseomgeving. De functionaliteit werkt native met zowel Delta Lake als Apache Iceberg.
De transacties sluiten aan op stored procedures, tijdelijke tabellen en SQL-scripting. Daardoor komen klassieke warehouse-workloads zoals data-inname, transformatie, business intelligence, applicaties en operationele analytics rechtstreeks op het Lakehouse beschikbaar. Databricks combineert dit met open tabelindelingen, governance en ondersteuning voor hoge gelijktijdigheid.
Lakehouse-transacties naast traditionele warehouses
Traditionele en cloudwarehouses leveren transactionele garanties, maar vereisen volgens Databricks vaak een gescheiden data-architectuur. Teams verplaatsen data dan tussen systemen, onderhouden extra kopieën en synchroniseren toegangsbeleid, audits en operationele controles. Ook bouwen ontwikkelaars eigen orkestratie, herstelmechanismen en controles om wijzigingen consistent te houden.
Databricks positioneert transacties op het Lakehouse als alternatief voor die constructie. Governed data hoeft niet naar een propriëtaire indeling of een tweede transactionele kopie. De ondersteuning voor Delta Lake en Apache Iceberg houdt de tabelindeling open, terwijl row-level concurrency gelijktijdige transacties op dezelfde tabel toestaat zolang ze niet dezelfde rij wijzigen.
Voor BI-omgevingen raakt dit vooral de laag achter rapportages en analytics. Datatransformaties over meerdere tabellen kunnen binnen één transactie worden uitgevoerd, in plaats van via losse stappen die teams zelf moeten afstemmen.
Concrete takeaway voor Databricks-gebruikers
Breng workflows in kaart waarin meerdere tabellen samen moeten wijzigen. Test daar multi-statementtransacties met Delta Lake of Apache Iceberg en controleer hoe stored procedures, SQL-scripting, pipelines en observability aansluiten. Vergelijk de uitkomst met de huidige warehouse-koppelingen, datakopieën en synchronisatielogica.
Verdiep je kennis
Kennisbank
Data lakehouse uitgelegd — Het beste van twee werelden
Wat is een data lakehouse en waarom combineert het het beste van data warehouses en data lakes? Vergelijking, architectu...
KennisbankWat is Power BI? Alles wat je moet weten
Ontdek wat Microsoft Power BI is, hoe het werkt, wat het kost en waarom het de populairste BI-tool ter wereld is. Comple...
KennisbankETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
Gerelateerde artikelen
Lakehouse: hoge prestaties netwerkanalyses met IP-functies
Databricks IP Functions brengen native IPv4- en IPv6-analyses naar het Lakehouse, zonder UDFs of regex.
Databricks: Google Sheets connector voor real-time data
Databricks lanceert een Google Sheets connector voor real-time toegang tot datalake-gegevens die rapportage en analyses ...

Lakehouse: introductie van native synchronisatie
Power BI krijgt native synchronisatie met Lakehouse waardoor dataverplaatsing zonder pipelines en extra kosten mogelijk ...

Open Lakehouse: Apache Iceberg™ v3 nu beschikbaar op Databricks
Databricks introduceert nu de openbare preview van Apache Iceberg v3, waarmee bedrijven hun data-architectuur kunnen opt...