Samenvatting
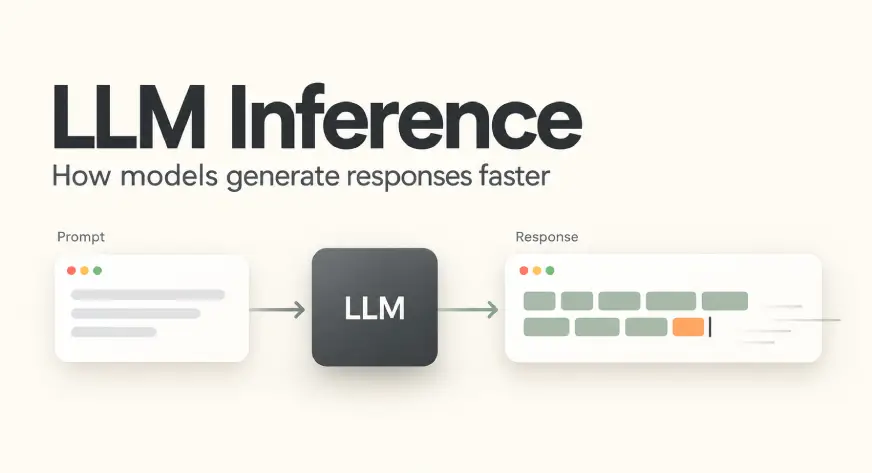
LLM-inferentie verklaart waarom AI-antwoorden eerst pauzeren en daarna token voor token verschijnen.
LLM-inferentie: wat er gebeurt
LLM-inferentie gebruikt een getraind taalmodel om nieuwe invoer te verwerken zonder de modelgewichten aan te passen. Het model voorspelt telkens het volgende token op basis van de prompt en de tokens die al zijn gegenereerd. Zo ontstaat een antwoord stap voor stap.
De verwerking begint met tokenization: tekst wordt omgezet in numerieke token-ID’s en embeddings. Daarna volgt prefill, waarbij het model de prompt door de transformerlagen verwerkt. Een prompt van 2.000 tokens kan daarbij meerdere posities parallel verwerken. De Key-Value-cache bewaart tussenresultaten voor de volgende tokens.
De eerste pauze en de daaropvolgende woordstroom hebben dus een verschillende technische oorzaak. GPU-geheugen, responssnelheid, throughput en bedrijfskosten bepalen samen hoe een AI-toepassing aanvoelt en draait.
LLM-inferentie en de impact op AI-applicaties
Voor BI-teams die taalmodellen in applicaties gebruiken, volstaat een beoordeling op basis van modelkwaliteit niet. De infrastructuur bepaalt ook hoeveel tijd een gebruiker wacht en hoeveel verzoeken een systeem verwerkt. Vooral het onderscheid tussen prefill en token generation helpt om vertraging gericht te onderzoeken.
De keuze van een inference-engine hoort bij die analyse. Het artikel bespreekt vLLM als engine die LLM-inferentie versnelt en behandelt daarnaast hardware, productiestructuren en meetmethoden. De bron noemt geen universele configuratie: de juiste keuze hangt af van de gemeten prestaties op de eigen machine.
Dat maakt de hands-on performance lab praktisch relevant. BI-professionals krijgen een manier om niet alleen de uiteindelijke responstijd te bekijken, maar ook de afzonderlijke stappen en hun belasting.
Concrete takeaway voor LLM-inferentie
Bouw de beschreven performance lab op je eigen machine en meet prefill, token generation, GPU-geheugen, throughput en responssnelheid afzonderlijk. Gebruik die metingen vervolgens om vLLM, hardware en de productiearchitectuur te beoordelen voordat je een AI-toepassing opschaalt.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen

Speculatieve decodering: LLM's genereren tekst 3x sneller
Grootschalige decodering maakt het mogelijk dat LLM's teksten drie keer sneller genereren, wat de toekomst van AI en zoe...
LLM Wiki Revolutie: Andrej Karpathy's idee verandert AI
Andrej Karpathy introduceert een revolutionair idee: de LLM Wiki, dat kunstmatige intelligentie transformeert in een hul...
Mamba4: snellere alternatieven voor Transformers in sequentieel modelleren
Mamba4 biedt een snellere en efficiëntere aanpak voor sequentieel modelleren, essentieel voor AI-toepassingen met lange ...
VLM's: werking van GPT-4o, Gemini, Claude Vision en Qwen-VL
VLM's maken beeld-AI bruikbaar voor taken in onderwijs, zakelijke toepassingen en meer.