Samenvatting
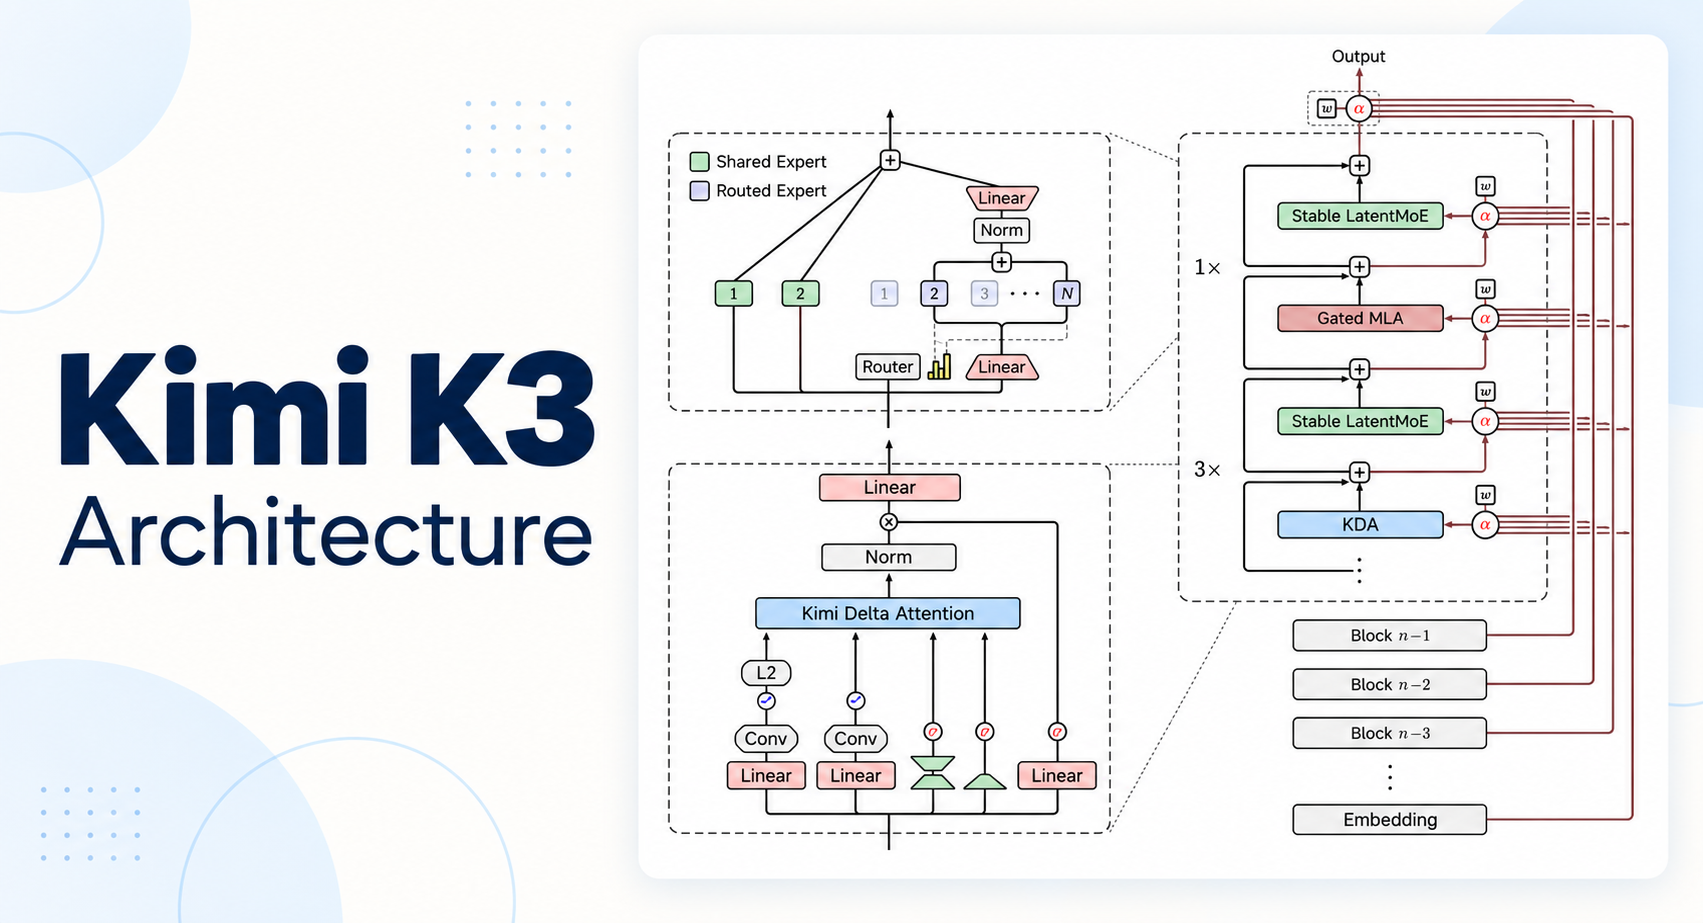
Kimi K3-architectuur: het model telt 2,8 biljoen parameters, maar activeert per token ongeveer 104 miljard experts.
Kimi K3-architectuur en modelgrootte
Kimi K3 is een open model van Moonshot met 2,8 biljoen parameters en 896 experts. Per token gebruikt het model ongeveer 104 miljard parameters. De overige gewichten blijven wel in het GPU-geheugen beschikbaar.
Bij 4-bit precisie nemen de gewichten ongeveer 1,4 TB in beslag. Een NVIDIA Blackwell Ultra B300 bevat 288 GB geheugen; een DGX B300-node met acht GPU’s komt uit op ongeveer 2,3 TB. Voor productiesystemen worden de experts daarom over grotere systemen verdeeld, zoals een NVL72-rack met 72 Blackwell-GPU’s.
Op 24 oktober 2026 verscheen Kimi K3.1 Pro. Die versie gebruikt dezelfde K3-basis met extra post-training. De architectuuranalyse blijft daardoor van toepassing.
Waarom Kimi K3 relevant is
K3 laat zien dat modelgrootte en gebruikskosten niet rechtstreeks aan elkaar gekoppeld zijn. Moonshot meldt dat K3 per token meer dan drie keer goedkoper is dan Claude Fable 5 tegen lijstprijzen. Op de onafhankelijke Artificial Analysis-index staat K3 volgens de bron drie punten achter Claude Opus 5.5; Moonshot vergelijkt het model ook met GPT-6 Astra.
De kostenbesparing komt uit meerdere ontwerpkeuzes. Mixture of experts beperkt het actieve deel per token, terwijl linear attention het verwerken van lange invoer ondersteunt. Attention residuals, Stable LatentMoE en NoPE richten zich eveneens op de manier waarop het model informatie leest en experts aanroept.
Tijdens het schrijven van een antwoord vormt geheugen de beperking: iedere nieuwe token moet gewichten en contextinformatie ophalen. Dat maakt de overdracht tussen GPU’s een bepalend onderdeel van de uitvoering.
Concrete takeaway voor Kimi K3
Wie Kimi K3 lokaal of in productie wil draaien, moet eerst de totale geheugenbehoefte en GPU-verbindingen berekenen. Alleen het actieve parameter-aantal volstaat niet: alle 2,8 biljoen gewichten moeten beschikbaar blijven, naast de KV-cache en ruimte voor gelijktijdige verzoeken.
Verdiep je kennis
Kennisbank
Predictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
Gerelateerde artikelen
Jev AI: praktische gids voor TypeSafe’s System One Model
Jev AI van TypeSafe geeft gestructureerde antwoorden met confidence scores voor classificatie, scoring en ja-of-neebesli...
GELU: werking en toepassing in transformers
GELU verwerkt inputs vloeiend en verklaart waarom BERT deze activatiefunctie boven ReLU gebruikt.

ML Stage: van prompt naar werkend Hugging Face-model
ML Intern richt zich op het oplossen van veelvoorkomende problemen in machine learning-projecten die leiden tot falen ti...

Top 7 Gratis Machine Learning Cursussen met Certificaten
Ontdek de beste gratis machine learning cursussen met certificaten om je vaardigheden in AI te verbeteren en je carrière...