Samenvatting
LLM-inferentiekaders regelen batching, KV-cachebeheer en API-serving voor modellen die meerdere verzoeken tegelijk verwerken.
LLM-inferentiekaders voor productie-serving
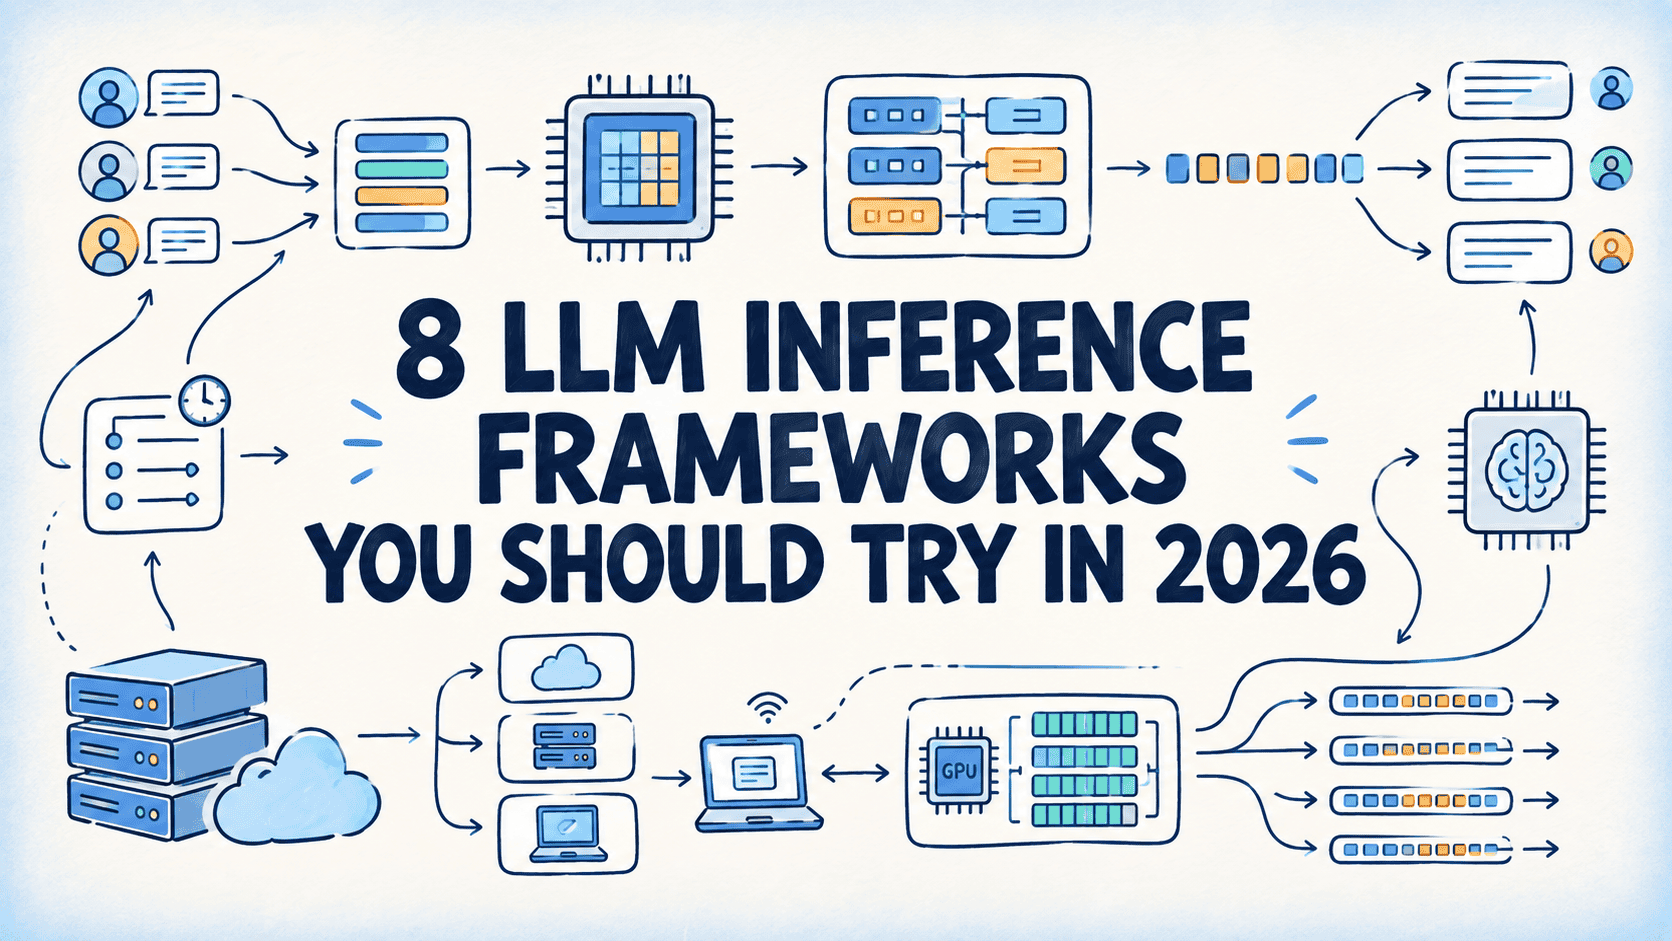
Een model dat in een notebook draait, verwerkt doorgaans één verzoek tegelijk. Een productie-endpoint krijgt meerdere verzoeken binnen; elk verzoek gebruikt GPU-geheugen voor de key-value-cache, vraagt een plek in de batch en levert een eigen responsstroom.
Plain PyTorch en Hugging Face Transformers kunnen een model serveren, maar request scheduling, cachebeheer en de API-laag moet je dan zelf bouwen. Inference frameworks plaatsen die onderdelen tussen het model en de applicatie. Het artikel bespreekt acht kaders voor productieomgevingen met hoge doorvoer en voor lokale, edge- en resourcearme omgevingen.
vLLM, SGLang en MAX vergeleken
vLLM gebruikt PagedAttention om de KV-cache in kleine blokken te beheren. Continuous batching laat nieuwe verzoeken aansluiten bij een batch die al draait. Het framework biedt een OpenAI-compatibele server, een in-process bibliotheek voor batchtaken en ondersteuning voor NVIDIA-, AMD- en Intel-GPU’s, naast CPU’s en TPU’s.
SGLang combineert een backend-runtime met een frontendtaal voor complexe promptlogica. RadixAttention hergebruikt de KV-cache wanneer verzoeken een prefix delen. Het framework ondersteunt gestructureerde uitvoer, constrained decoding, diffusion-modellen en zowel server- als in-processgebruik.
MAX van Modular geeft controle tot op kernelniveau. Daarmee positioneert het artikel dit kader anders dan oplossingen die vooral de serverlaag abstraheren. De acht besproken opties bedienen dus niet één type werklast.
Concrete takeaway voor LLM-serving
Breng eerst het serveerprofiel in kaart: gelijktijdige verzoeken, complexe generatiepaden, gestructureerde uitvoer, hardware en deploymentlocatie. Test daarna gericht met vLLM, SGLang of MAX en meet latency, batchgedrag en GPU-geheugengebruik. Controleer ook of een OpenAI-compatibele API, een in-process bibliotheek of ondersteuning voor jouw hardware nodig is.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen

Vijf Agentic AI-frameworken voor 2026 om te kennen
Wet TTA wordt verlengd en beïnvloedt de audiovisuele sector in 2026.
5 gratis AI-codingagents om te proberen in 2026
AI-codingagents maken krachtige modellen gratis toegankelijk via OpenCode Zen, Gemini CLI, Kilo Gateway, Cline Provider ...
Gratis LLM API-providers voor 2026
Gratis LLM API-providers geven in 2026 toegang tot grote modellen zonder kosten per API-aanroep, voor experimenten en pr...

Top 7 coderingsmodellen voor lokaal gebruik in 2026
Power BI krijgt sterke AI-tools die lokale codering revolutioneren.