Samenvatting
Cortex Training maakt serverless fine-tuning van open-weight LLMs mogelijk zonder GPU-infrastructuur zelf te beheren.
Cortex Training biedt serverless fine-tuning
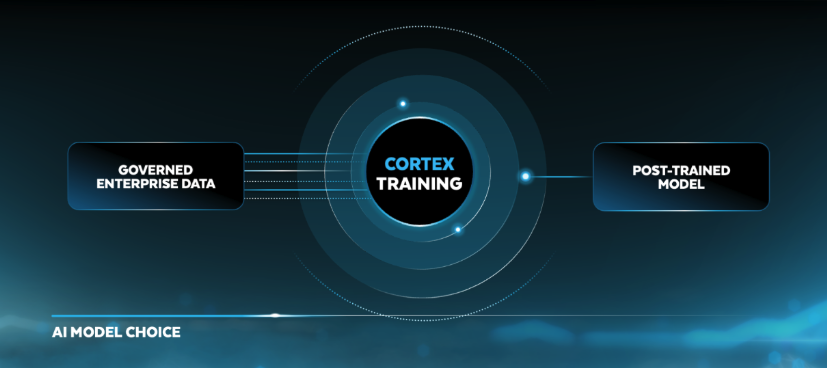
Snowflake heeft op 3 november 2026 de publieke preview van Cortex Training aangekondigd. De dienst ondersteunt het aanpassen en uitrollen van open-weight LLMs via vertrouwde trainingsframeworks en serverless API’s op laag niveau.
Teams hoeven daarbij GPU-provisioning, planning, checkpointing en gedistribueerde uitvoering niet zelf te regelen. Snowflake meldt dat benchmarks tot 61% lagere kosten laten zien dan concurrerende serverless diensten.
Cortex Training gebruikt een open-source backend die volgens Snowflake de flexibiliteit van een zelf beheerd bare-metalcluster combineert met een serverless werkwijze. De dienst sluit aan op Snowflakes geïntegreerde dataplatform, waarmee teams trainingsdatasets samenstellen en agent-traces en logs verzamelen.
Waarom Cortex Training relevant is
De keuze gaat hier niet alleen over modelkwaliteit. Gesloten foundation models bieden weinig ruimte voor aanpassing aan bedrijfsspecifieke data en context, terwijl zelf beheerde GPU-infrastructuur technische complexiteit en kosten meebrengt. Beheerde API’s lossen een deel van dat beheer op, maar beperken volgens Snowflake de flexibiliteit en controle.
Cortex Training richt zich op post-training van open-weight modellen. Supervised fine-tuning leert een model gewenst gedrag aan de hand van voorbeelden, zoals diagnose, escalatieregels en toolgebruik. Reinforcement learning richt zich op beslissingen die gewenste uitkomsten opleveren.
De combinatie van trainingsdata, agent-logs en modelaanpassing maakt de datastroom binnen Snowflake onderdeel van hetzelfde proces. Dat onderscheidt de dienst van een losse model-API of een afzonderlijk GPU-cluster.
Concrete takeaway voor Cortex Training
Beoordeel Cortex Training in de publieke preview op drie punten: de benodigde controle over het model, de beschikbare trainingsdata en de werkelijke kosten tegenover een beheerde API of eigen GPU-infrastructuur. Controleer daarnaast of bestaande SFT- en RL-frameworks aansluiten op de serverless API’s.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankData lakehouse uitgelegd — Het beste van twee werelden
Wat is een data lakehouse en waarom combineert het het beste van data warehouses en data lakes? Vergelijking, architectu...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
Gerelateerde artikelen

Snowflake Cortex AI: dynamische modelrouting en open modellen
Snowflake Cortex AI introduceert dynamische modelrouting en open modellen voor kostenoptimalisatie.

FinOps Versnellen met Cortex Code op Snowflake
Snowflake Cortex Code versnelt FinOps met AI-gestuurde forecasting en automatisering, wat financiële processen transform...

Snellere AI-gegevensengineering op Snowflake met Cortex Code-updates
Snowflake introduceert Cortex Code-updates, waardoor AI-gegevensengineering efficiënter wordt en sneller kan worden opge...

Cortex Code CLI Breidt Uit naar Ondersteuning van Elke Data, Overal
Cortex Code CLI breidt zijn functionaliteit uit en ondersteunt nu alle datasystemen, met een focus op data engineering t...