Samenvatting
Snowflake verbindt streaming, transformatie en datalevering voor real-time analytics zonder losse systemen per stap.
Snowflake en real-time analytics: wat er gebeurt
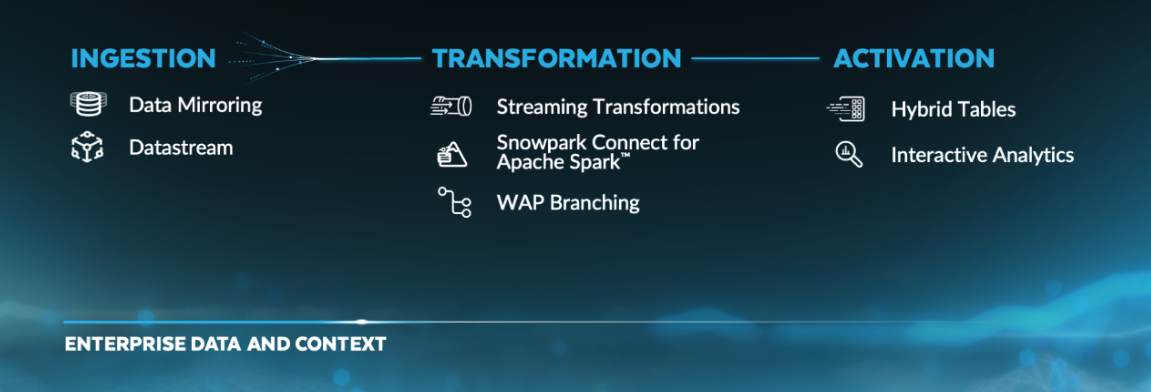
Snowflake introduceert een geïntegreerde aanpak voor real-time analytics. De oplossing brengt verbinding, transformatie en datalevering samen voor Snowflake native tables en Apache Iceberg-tables.
Real-time analytics verwerkt gebeurtenissen terwijl ze plaatsvinden, zodat mensen en systemen binnen seconden over actuele informatie beschikken. Snowflake beschrijft toepassingen voor financiële dienstverlening, netwerkbeheer, retail en AI-agents. Denk aan actuele marktdata, netwerkproblemen tijdens een supportgesprek en voorraadbeslissingen op basis van de vraag van dat moment.
De aanpak richt zich op drie onderdelen: data verbinden, data tijdens de verwerking aanpassen en resultaten snel beschikbaar stellen. Teams hoeven daarbij niet voor elke toepassing hun architectuur opnieuw op te bouwen.
Waarom Snowflake real-time analytics belangrijk maakt
Een traditionele real-time stack bestaat volgens Snowflake vaak uit afzonderlijke onderdelen. Producenten leveren data aan een message broker, aparte transformatietaken verwerken die data en een andere database bewaart de resultaten. Elk onderdeel vraagt eigen infrastructuur, gespecialiseerde kennis, beveiligingsregels en onderhoud.
Snowflake positioneert de geïntegreerde aanpak als alternatief voor die versnippering. De combinatie van Snowflake native tables en Apache Iceberg-tables laat teams hun bestaande keuzevrijheid voor engines en tools behouden. Tegelijk verschuift de aandacht van het koppelen van losse lagen naar het beheren van één samenhangende gegevensstroom.
Voor BI-architecten zit de belangrijkste verandering daarom niet alleen in snelheid. Ook de plaats van transformatie, de manier waarop actuele gegevens worden geserveerd en de governance per stap horen bij dezelfde inrichting. De juiste latency blijft afhankelijk van de workload.
Concrete takeaway voor Snowflake real-time analytics
Breng eerst de volledige keten van een actuele datastroom in kaart: bron, message broker, transformatie, opslag en levering. Vergelijk die inrichting daarna met Snowflakes combinatie van native tables en Apache Iceberg-tables. Let vooral op welke stappen nu afzonderlijk worden beheerd en welke engines of tools je wilt blijven gebruiken.
Verdiep je kennis
Kennisbank
Data lakehouse uitgelegd — Het beste van twee werelden
Wat is een data lakehouse en waarom combineert het het beste van data warehouses en data lakes? Vergelijking, architectu...
KennisbankETL uitgelegd — Extract, Transform, Load in gewone taal
Wat is ETL? Leer hoe Extract, Transform en Load werkt, het verschil met ELT, en welke tools je kunt gebruiken. Helder ui...
Gerelateerde artikelen

Real-time datastromen via Snowpipe Streaming in Snowflake
Snowpipe Streaming biedt realtime data-invoer direct in Snowflake met eenvoudige setup zonder staging. Financiële dienst...

Debezium vervangen door Openflow | Bijna Real-Time CDC voor Snowflake
Een zorgklant heeft Debezium vervangen door Snowflake Openflow voor het vereenvoudigen van Change Data Capture (CDC) pip...

Snowflake: Postgres verenigt apps, analytics en AI
Snowflake Postgres verenigt naadloos apps, analytics en AI met nieuwe data-mirroring en data lake-integraties.
Snowflake Postgres: Vereenvoudig Postgres en Analyse op Eén Platform
Snowflake Postgres vereenvoudigt de gegevensbeweging door complexe pijplijnen te elimineren, waardoor realtime analytics...