Samenvatting
Polars verwerkt data met lazy query-planning, streaming en parallelle uitvoering via een nieuwe KDnuggets-gids.
Polars: lazy query-planning in de KDnuggets-gids
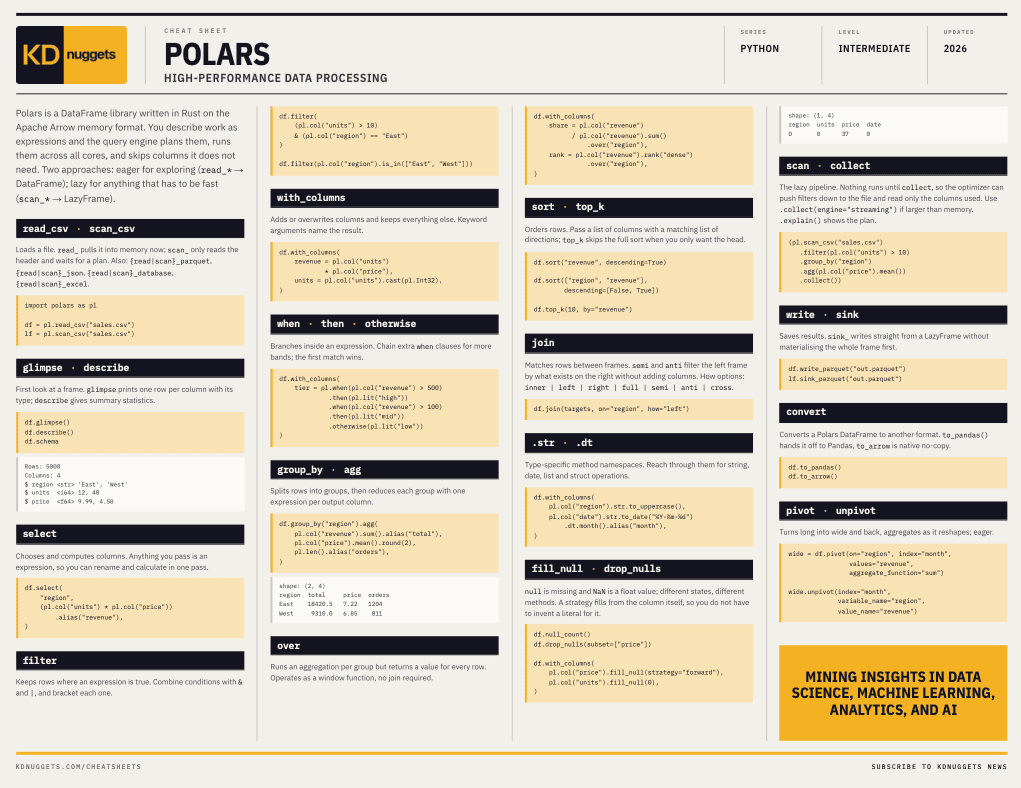
KDnuggets publiceerde op 23 september 2026 een cheatsheet over Polars, een DataFrame-bibliotheek in Rust die het Apache Arrow-geheugenformaat gebruikt. De bibliotheek beschrijft bewerkingen als expressions; de query-engine bepaalt daarna hoe hij die uitvoert, onder meer over beschikbare cores en met alleen de benodigde kolommen.
De gids legt vooral het verschil uit tussen directe en uitgestelde uitvoering. `read_csv` leest een bestand meteen in, terwijl `scan_csv` eerst alleen de header bekijkt. Pas bij `collect` voert Polars de opgebouwde bewerkingen uit. Daardoor kan de optimizer filters naar het bestand verplaatsen en ongebruikte kolommen overslaan. Met `collect(engine="streaming")` verwerkt Polars bestanden die niet volledig in het geheugen passen in delen.
Waarom Polars relevant is voor BI en analytics
Polars verschuift een deel van het werk van losse bewerkingsstappen naar de queryplanning. Dat vraagt om een andere manier van pijplijnen schrijven: niet elke regel voert direct iets uit. De gekozen expressions bepalen mede welke optimalisaties de engine kan toepassen.
De cheatsheet behandelt ook window functions via `over`, waarmee je bijvoorbeeld het aandeel van een regio in het eigen totaal of een rangorde binnen een categorie berekent zonder aparte `groupby`- en join-stap. Daarnaast maakt de gids een onderscheid dat in controles belangrijk blijft: `null` staat voor ontbrekende waarden, terwijl `NaN` een echte waarde van het type float is.
Polars hoeft bestaande Pandas- of Arrow-processen niet volledig te vervangen. De functies `to_pandas` en `to_arrow` bieden expliciete overdrachten. Voor uitvoer schrijft `sink_parquet` een lazy frame rechtstreeks weg zonder het eerst volledig te materialiseren.
Concrete takeaway voor Polars
Gebruik bij bestandspijplijnen eerst `scan_csv`, bouw de bewerkingen met `select`, `filter` en `with_columns` op en roep daarna `collect` aan. Kies streaming voor bestanden die niet in het geheugen passen, controleer `null` en `NaN` afzonderlijk en gebruik `sink_parquet` wanneer materialisatie onnodig is.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen

Polars: drie trucs voor efficiënte datamanipulatie
Polars laat met drie trucs zien hoe Rust en query-optimalisatie trage datamanipulatie aanpakken.
Scikit-LLM: handige cheat sheet voor estimators
Scikit-LLM koppelt taalmodellen aan scikit-learn, met ZeroShotGPTClassifier en GPTVectorizer voor herbruikbare pipelines...

5 Krachtige Python Decorators voor High-Performance Data Pipelines
Python-decorators kunnen de prestaties van data pipelines aanzienlijk verbeteren door herbruikbare en efficiënte code te...

Scikit-Learn: handige cheat sheet voor feature engineering
Scikit-Learn feature engineering krijgt van KDnuggets een cheat sheet voor preprocessing en modeltuning in Pipelines.