Samenvatting
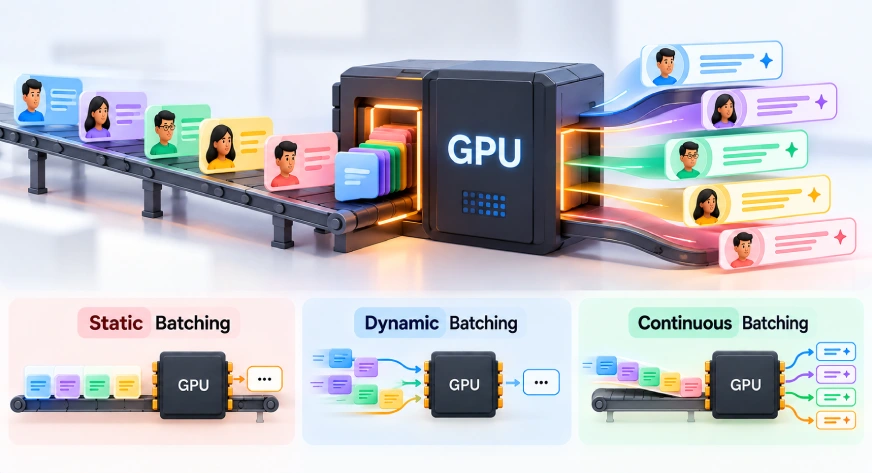
LLM-batching vergelijkt statische, dynamische en continue verwerking voor beter GPU-gebruik, hogere doorvoer en passende responstijden.
LLM-batching: drie manieren om verzoeken te verwerken
Batching verwerkt meerdere invoeren in één forward pass, in plaats van elk verzoek afzonderlijk uit te voeren. Bij een LLM bestaan die invoeren uit tokenreeksen. De GPU verwerkt daardoor meerdere verzoeken parallel, terwijl de server bepaalt hoe binnenkomende aanvragen worden gegroepeerd en wanneer vrijgekomen capaciteit opnieuw wordt gebruikt.
Het artikel vergelijkt static batching, dynamic batching en continuous batching. Die keuze beïnvloedt volgens de bron zowel de snelheid waarmee gebruikers antwoord krijgen als de kosten per verzoek. De technische verklaring ligt vooral bij de decodefase: het model genereert daar token voor token en leest bij iedere stap de modelgewichten opnieuw uit het GPU-geheugen.
GPU-geheugen bepaalt waarom LLM-batching telt
Bij een 7B-model in FP16 nemen de gewichten ongeveer 14 GB in beslag. Een H100 heeft een geheugenbandbreedte van ongeveer 3,35 TB/s, waardoor het lezen van die gewichten ongeveer 4 milliseconden duurt. Dat begrenst één verzoek tot ongeveer 240 tokens per seconde.
De GPU rekent daarbij nauwelijks op volle capaciteit. Eén token vraagt ongeveer 14 GFLOPs, wat bij deze leestijd neerkomt op circa 3,5 TFLOPS, tegenover bijna 1.000 TFLOPS aan dense BF16-capaciteit op de H100. Bij batchgrootte één blijft daardoor meer dan 99 procent van de rekenkracht ongebruikt. Met 32 reeksen worden de gewichten in dezelfde stap één keer gelezen voor 32 tokens in plaats van één.
Concrete takeaway voor LLM-serving
Breng bij een inference-workload eerst de verhouding tussen prefill en decode in kaart. Vergelijk daarna static, dynamic en continuous batching op drie meetpunten: GPU-gebruik, doorvoer en responstijd. Kijk niet alleen naar batchgrootte; de manier waarop de server verzoeken toevoegt en verwijdert bepaalt mede hoeveel geheugenlezingen meerdere aanvragen delen.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen
LLM-inferentie: sneller modellen laten reageren
LLM-inferentie verklaart waarom AI-antwoorden eerst pauzeren en daarna token voor token verschijnen.

AI-geheugenlagen: van Karpathy’s LLM Wiki naar Graphify
De introductie van AI-geheugenlagen belooft een revolutie in de efficiëntie van AI-workflows door context te behouden.
Gemma 4 Tool: stap voor stap AI-agents bouwen met function calling
Gemma 4 Tool introduceert function calling, waardoor AI-agents live data kunnen ophalen en nauwkeurige antwoorden geven.

10 essentiële AI-concepten eenvoudig uitgelegd
De tien belangrijkste AI-concepten zijn eenvoudig uitgelegd, zodat BI-professionals beter kunnen navigeren door de compl...