Samenvatting
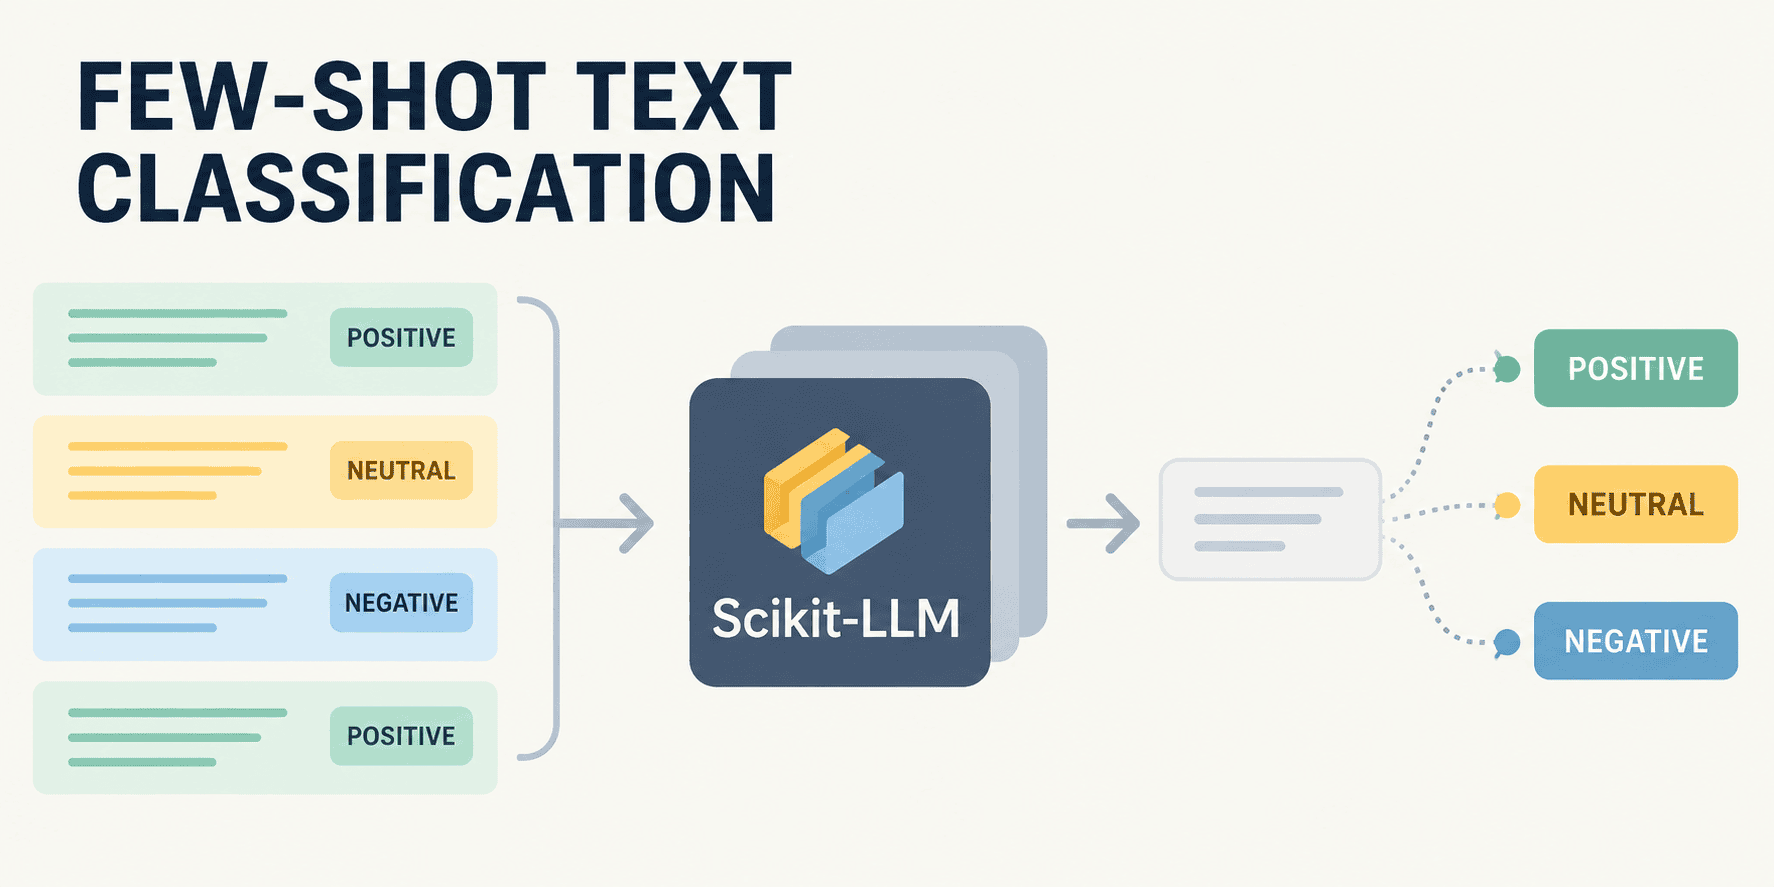
Scikit-LLM classificeert tekst met drie tot vijf gelabelde voorbeelden, zonder het volledige model opnieuw te trainen.
Scikit-LLM: wat er gebeurt
Scikit-LLM koppelt vooraf getrainde large language models aan de vertrouwde scikit-learn-interface met fit() en predict(). Daardoor kunnen gebruikers tekst classificeren via prompt engineering, zonder eerst honderden tot duizenden gelabelde voorbeelden te verzamelen, tekst op te schonen en embeddings of TF-IDF te bouwen.
Het artikel laat zien hoe few-shot classificatie werkt in een Google Colab-notebook met de API van Groq. De gebruiker geeft drie tot vijf gelabelde voorbeelden mee; het model gebruikt die voorbeelden vervolgens als extra aanwijzingen bij het indelen van nieuwe tekst.
Waarom Scikit-LLM belangrijk is
Scikit-LLM vormt een tussenlaag tussen klassieke machine-learningprocessen en LLM-gebaseerde classificatie. Een traditionele aanpak kan een logistieke regressie of random forest trainen op numerieke tekstrepresentaties. De Scikit-LLM-aanpak gebruikt daarentegen een vooraf getraind model en enkele voorbeelden, zonder het hele model opnieuw te trainen.
Het onderscheid met zero-shot classificatie is praktisch. Bij zero-shot krijgt het model alleen tekst en mogelijke labels. Few-shot voegt gelabelde voorbeelden toe, zodat domeintermen, uitzonderingen en genuanceerde sentimenten duidelijker worden. Volgens het artikel werkt die aanpak doorgaans beter voor sterk domeinspecifieke teksten.
Voor BI-teams ligt de waarde vooral in de lagere instap voor teksttaken waarvoor nog geen grote trainingsset bestaat. Tegelijk verschuift een deel van het werk naar het kiezen van labels en voorbeelden. De kwaliteit van die input bepaalt mede hoe bruikbaar de classificatie wordt.
Concrete takeaway voor Scikit-LLM
Test Scikit-LLM eerst met drie tot vijf zorgvuldig gekozen voorbeelden per classificatietaak en vergelijk de uitkomsten met zero-shot classificatie. Leg daarna vast welke labels, voorbeelden en prompts de beste resultaten geven voordat je de aanpak in een terugkerende BI-stroom opneemt.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen

Named Entity Recognition met Scikit-LLM
Scikit-LLM maakt custom Named Entity Recognition mogelijk met LLM-redenering en gestandaardiseerde pipelines in een paar...
Scikit-LLM: handige cheat sheet voor estimators
Scikit-LLM koppelt taalmodellen aan scikit-learn, met ZeroShotGPTClassifier en GPTVectorizer voor herbruikbare pipelines...

LLM engineer worden: roadmap voor 2026
LLM engineer worden: roadmap voor 2026 benadrukt de vaardigheden nodig om LLM-applicaties succesvol te implementeren.
ML Engineer of AI Engineer: welke rol bouwt wat in 2026?
ML Engineer, AI Engineer en LLM Engineer bouwen in 2026 verschillende producten, ondanks vrijwel identieke vacaturetitel...