Samenvatting
Agentic RAG vond op 298 vragen zowel gemiste als verloren papers, maar leverde te weinig bewijs om het te vertrouwen.
Wat Agentic RAG deed
In een test liet de auteur een AI-agent opnieuw zoeken wanneer die daar zelf voor koos. De aanpak werd beoordeeld op 298 vragen en vergeleken met plain search.
De agent vond papers die de gewone zoekmethode had gemist. Tegelijk verloor Agentic RAG ook papers die plain search wel had gevonden. De extra opbrengst bleef daardoor te klein om de methode zonder aanvullende controle te vertrouwen.
Waarom Agentic RAG belangrijk is
De test maakt een praktisch onderscheid zichtbaar tussen meer zoekacties en betere bewijsvoering. Een agent die zelfstandig opnieuw zoekt, vergroot de verzameling bronnen niet automatisch op een betrouwbare manier. De uitkomst hing hier af van wat de agent wel en niet opnieuw oppakte.
Dat raakt BI-toepassingen waarin een antwoord niet alleen plausibel moet klinken, maar ook terug te voeren moet zijn op de juiste bron. Agentic RAG voegt een beslismoment toe aan het zoekproces: de agent bepaalt wanneer een nieuwe zoekactie nodig is. De testresultaten laten zien dat die keuze zowel ontbrekende papers kan aanvullen als eerder gevonden papers buiten beeld kan brengen.
Daarom volstaat een vergelijking met alleen het aantal gevonden documenten niet. De kwaliteit van de gevonden onderbouwing en het behoud van relevante bronnen tellen tegelijk mee. Plain search blijft in deze test een noodzakelijke referentie.
Concrete takeaway voor Agentic RAG
Gebruik Agentic RAG niet als vervanging van plain search. Test beide routes op dezelfde vragen, controleer welke papers elke methode mist en leg vast welke bronnen het uiteindelijke antwoord onderbouwen. De uitkomst van 298 vragen geeft geen basis om extra zoekrondes zonder menselijke controle te vertrouwen.
Verdiep je kennis
Kennisbank
ChatGPT en BI — Hoe AI je data-analyse verandert
Ontdek hoe ChatGPT en generatieve AI de wereld van business intelligence veranderen. Van SQL en DAX genereren tot data-a...
KennisbankAI in Power BI — Copilot, Smart Narratives en meer
Ontdek alle AI-functies in Power BI: van Copilot en Smart Narratives tot anomaliedetectie en Q&A. Compleet overzicht met...
KennisbankPredictive Analytics — Wat kan het voor jouw bedrijf?
Ontdek wat predictive analytics is, hoe het werkt en hoe je het inzet voor je bedrijf. Van de 4 niveaus van analytics to...
Gerelateerde artikelen
AI Agents: uitleg van ReAct-loop en werking
AI Agents maken met de ReAct-loop complexe beslissingen ene fase per keer mogelijk.
Podcast-knipselapp Vibe Coding in één weekend gebouwd
Een ontwikkelaar heeft in een weekend een podcast-knipselapplicatie gebouwd met behulp van Vibe Coding, waardoor snel pr...

Van Dashboards naar Beslissingen: Data & Analytics in het AI-tijdperk
De opkomst van AI-technologieën transformeert de manier waarop bedrijven data en analyses gebruiken om beter geïnformeer...
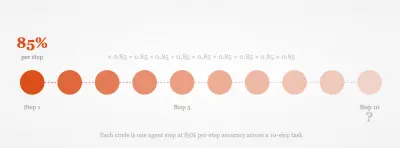
De wiskunde die jouw AI-agent schaadt
Een onnauwkeurige AI-agent kan met 85% precisie toch falen in 80% van de gevallen bij complexe taken.